Ukazují vaše Power BI reporty pro stejnou věc různá čísla?
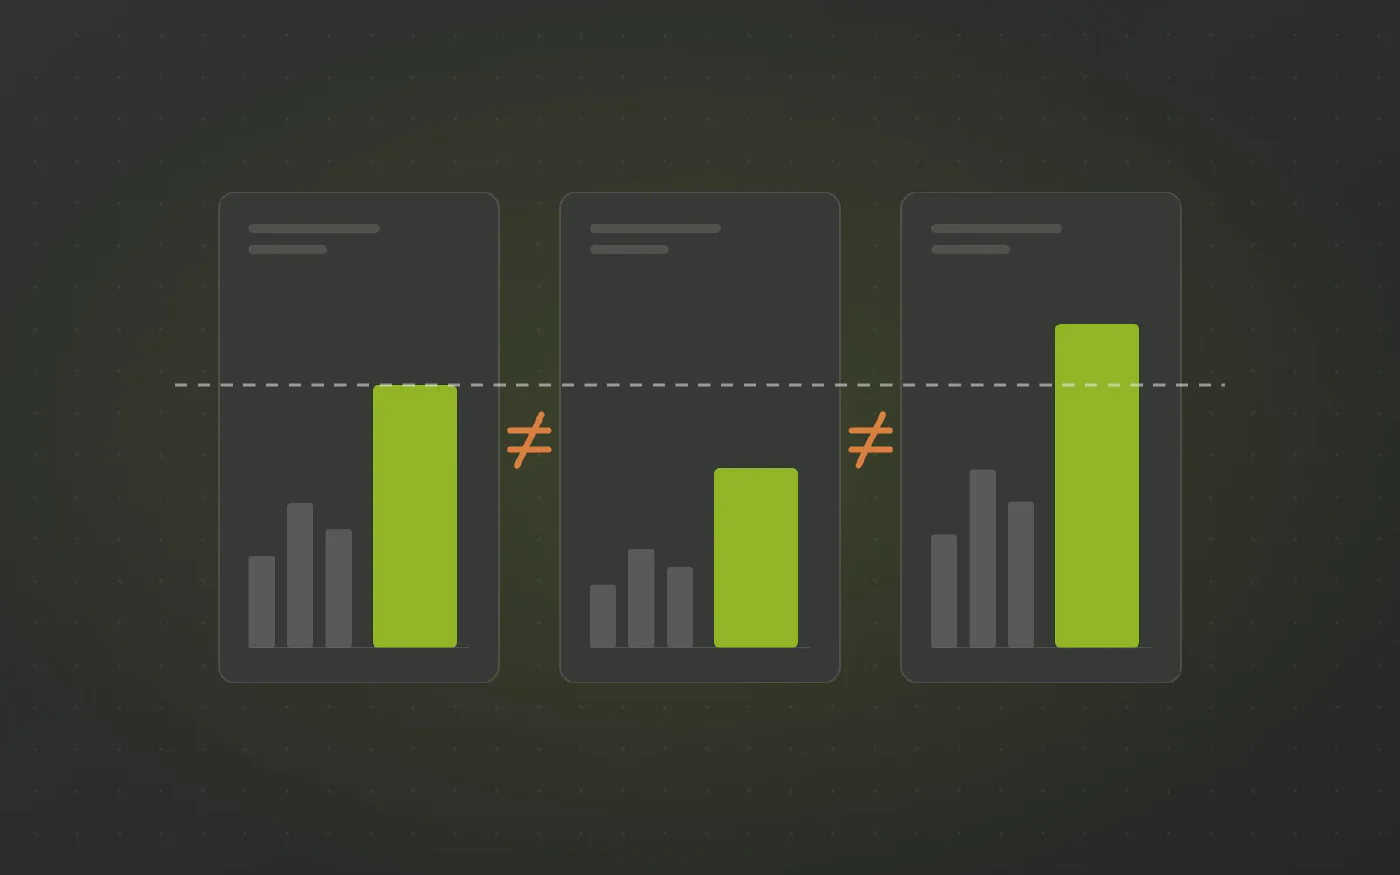
Finance, Obchod i Provoz si každý postavili vlastní sémantický model a každý z nich je vnitřně konzistentní. Definice nebyly špatně na jednom místě. Nebyly dohodnuté nikde.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory
Zní vám to povědomě?
- Tři dashboardy ukazují za stejný měsíc tři různá čísla tržeb a každý autor to své obhájí.
- Nikdo neví, kolik sémantických modelů existuje, natož který z nich je ten důvěryhodný.
- "Aktivní zákazník" znamená v Obchodu něco jiného než ve Financích.
- Ráno před poradou čísla odsouhlasujete, místo abyste je vysvětlovali.
Každý model v tenantu je vnitřně konzistentní. Problém je, že definice tržeb vznikla v každém z nich nezávisle.
Proč se čísla rozcházejí
- Byznys logika žije v reportu. Každý
.pbixobsahuje vlastní filtry a výjimky. - Kopírování bylo nejrychlejší cestou k výsledku. Nová otázka znamenala nový model, ne úpravu sdíleného.
- Rozdíly nejsou vidět. Tři measures s názvem “Net Revenue” vypadají zvenku úplně stejně.
- Definici nikdo nevlastní, takže nikdo nemůže rozhodnout, když se liší.
Certifikované datasety pomáhají, ale až poté, co někdo rozhodne, jaké to číslo je. Toto rozhodnutí není funkcí Power BI.
Proč to dopadá na vás
- Máte vysvětlit rozdíl, který vznikl rozhodnutími ve třech odděleních.
- Odsouhlasování čísel je neviditelná práce. Všimne si jí někdo, až když se neudělá.
- Svůj report sladit můžete. Přimět tři týmy ke sdílení jedné definice nemůžete.
Práce se dělá na špatném místě
- Definovat tržby je práce pro datový sklad. Když se dělá zvlášť v každém
.pbix, vzniknou tři odpovědi. - Patří na jedno centrální místo: do datového skladu nebo data hubu, který se postaví jednou a čte z něj každý report.
- Pokud to zní draze, odhad nejspíš počítá s tím, že se datové pipeline budou stavět ručně. Specializovaná automatizační platforma je generuje z modelu, a to mění náklady i čas, který to zabere.
Co se změní, když model přijde hotový
Datavault Builder uloží byznys pravidla do datového skladu, jednou, a vygeneruje dimenzionální pohledy, které čte každý report.
- Tržby se počítají na jednom místě a každý workspace pracuje se stejným číslem.
- Pravidlo je vidět, dá se zrevidovat a je pod správou verzí, ne zahrabané v souboru.
- Lineage ukazuje odvození, takže spor vyřeší otevření grafu.
- Nové otázky znovu využijí model, místo aby vznikla další jeho kopie.
- Odsouhlasování přestane být opakovaným úkolem, protože nebude co odsouhlasovat.
O co požádat
“Finance a Obchod počítají čisté tržby odlišně a obě varianty žijí uvnitř Power BI modelů. Může se pravidlo definovat jednou v datovém skladu, aby každý report četl stejný dimenzionální pohled?”
Tím se debata posune od toho, čí report má pravdu, k tomu, kde má definice žít.
Podívejte se, jak to funguje na vašich vlastních datech
Rezervujte si bezplatné demo a přineste report, se kterým máte největší potíže.
Tři kroky k číslům, která sedí
-
Vytáhněte stávající logiku
Posbírejte výpočty, joiny a filtry, které dnes žijí ve vašich reportech.
-
Centralizujte ji na jednom místě
Logika se jednou přesune do modelu datového skladu, takže každý report čte stejnou definici.
-
Čísla, která sedí
Každý report ukazuje stejné číslo a “odkud se tohle číslo vzalo” má viditelnou odpověď.
Jak Datavault Builder předá vašemu reportu hotový model
-
Model přijde hotový
Datavault Builder generuje vault a star schema tak, aby běžely nativně v databázi, kterou už máte: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks nebo BigQuery.
-
Práce opustí report
Žádný merge, žádné parsování, žádný fuzzy match. Tato práce z reportu zmizela.
-
Zdroje přicházejí integrované
Zákazníci z ERP, CRM a e-shopu se spárují do jedné sady konformních dimenzí. Join proběhne jednou v datovém skladu, ne znovu v každém reportu.
-
Historie, na kterou se lze dotázat
Každá změna se uchová tak, jak přijde, takže můžete reportovat stav tehdy i stav nyní, i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Každé číslo má lineage
Logika získá lineage, takže otázka “odkud se tohle číslo vzalo” má viditelnou odpověď.
-
Změny řešené výše v řetězci
Pomalu se měnící dimenze se řeší výše v řetězci jako vault satelity, místo aby se jen aproximovaly.
Příběh zákazníka: Porta
Oceněno společností BARC v The Data Fabric Survey 26
Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí do vaší situace.
Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Je váš Power BI report v DirectQuery pomalý při každém kliknutí?
DirectQuery a Direct Lake slibují živá data. Dostanete třicetisekundový vizuál a účet za výpočetní výkon, který nikdo nechce vysvětlovat. Problém není v režimu. Je ve schématu pod ním.
-
Je váš DAX v Power BI už příliš dlouhý na údržbu?
Dvě stě řádků CALCULATE a FILTER není známka pokročilého DAX. Obvykle je to známka toho, že vám datový sklad nikdy nedal klíče, historii ani granularitu, kterou jste potřebovali.
-
Selhává vám refresh v Power BI každou noc?
Naplánovaný refresh skončí timeoutem, Power Query dojde paměť a vy se to dozvíte, až když někdo otevře dashboard. Příčinou téměř nikdy není Power BI. Je to práce, kterou po Power BI chcete.