Explodiert Ihre Fivetran-Rechnung jedes Mal, wenn sich in einer Quelltabelle viel bewegt?
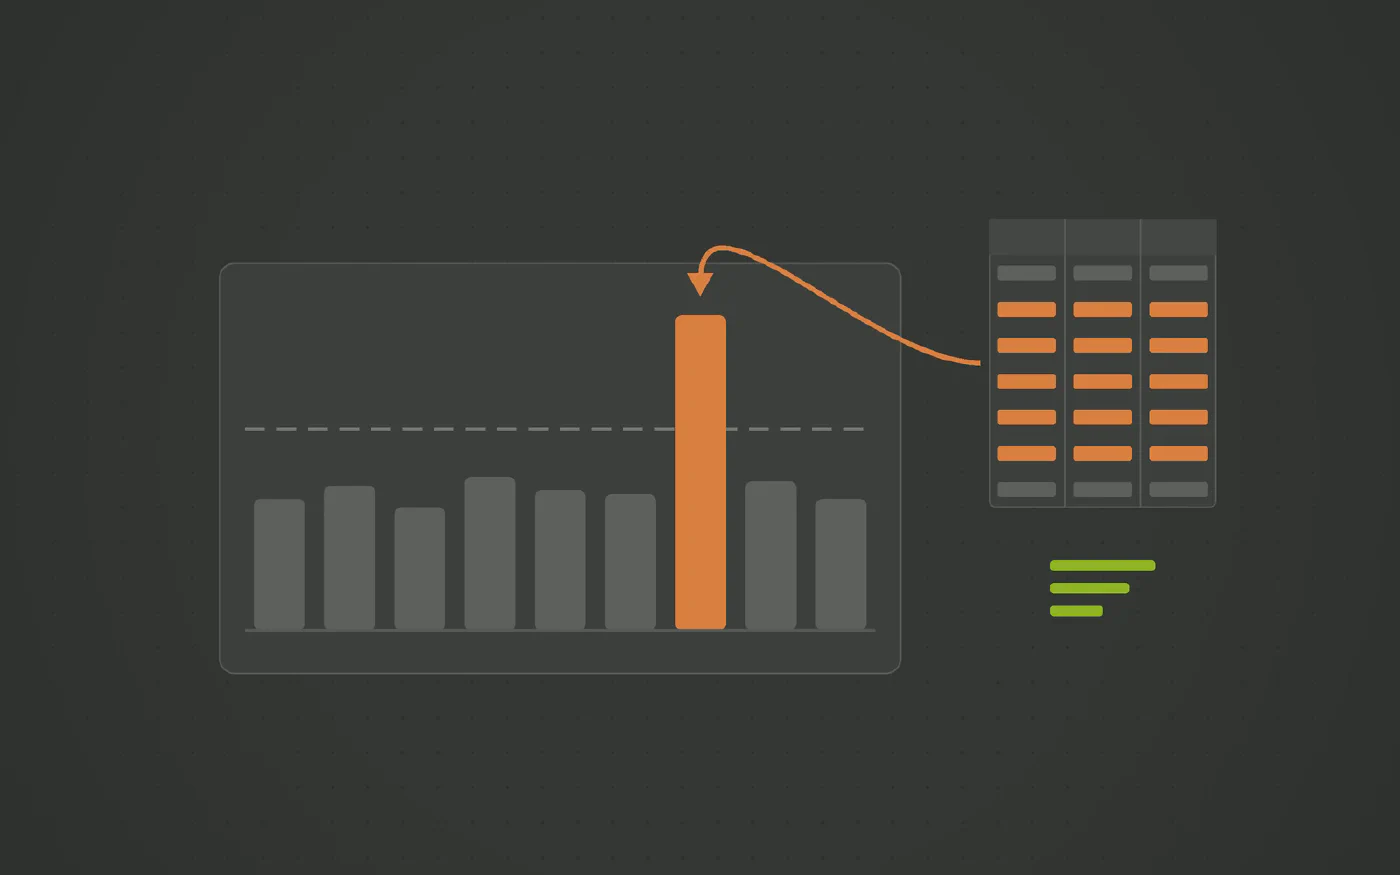
Fivetran rechnet nach Monthly Active Rows ab. Ein Bulk-Update oder eine Schemamigration im Quellsystem berührt jede Zeile erneut, und die Rechnung folgt. Die Zeilen waren nie das Problem. Teuer wird es, wenn Sie pro Zeile für Daten zahlen, die Sie anschließend ohnehin selbst noch einmal verarbeiten.
Die Data-Warehouse-Automationsplattform, der Datenteams aus vielen Branchen vertrauen









Kommt Ihnen das bekannt vor?
- Die Rechnung für den Monat einer ERP-Migration ist ein Vielfaches des Vormonats, und niemand hat damit geplant.
- Ein Quellsystem-Team fährt ein Bulk-Update, und Ihre Ingestion-Rechnung fängt es auf.
- Sie entscheiden inzwischen danach, was eine Tabelle an Synchronisation kostet, statt danach, was das Business braucht.
- Finance bittet um eine Prognose der Ingestion-Kosten, und die ehrliche Antwort hängt davon ab, was das ERP-Team im nächsten Quartal macht.
Monthly Active Rows (MAR) sind eine vernünftige Art, einen Connector abzurechnen. Zum Problem werden sie, wenn jemand anderes entscheidet, wie viele Zeilen sich ändern. Eine Preisanpassung per Bulk-Update im ERP, eine Schemamigration, die eine Spalte für jeden Datensatz neu schreibt, eine Datenqualitätsbereinigung, die die halbe Kundentabelle berührt: Jede davon zählt jede betroffene Zeile erneut als aktiv, und die Rechnung kommt im Nachhinein.
Warum Sie die Rechnung nicht in der Hand haben
- MAR zählt berührte Zeilen, nicht relevante Zeilen. Eine Migration, die eine Spalte in zehn Millionen Datensätzen ändert, sind zehn Millionen aktive Zeilen, auch wenn sich weiter unten nichts ändern musste.
- Der Kostenauslöser liegt außerhalb Ihrer Kontrolle. Quellsystem-Teams fragen vor einer Bulk Operation nicht das Ingestion Budget, und das sollten sie auch nicht müssen.
- Dieselbe Zeile wird zweimal bezahlt. Einmal auf dem Weg hinein, und noch einmal als Compute, wenn die Landing-Tabelle komplett neu verarbeitet wird, weil weiter unten niemand weiß, welche Zeilen sich geändert haben.
- Kostenprognosen werden zur Kaffeesatzleserei. Der Connector misst Aktivität, und Aktivität ist eine Funktion dessen, was andere Teams tun.
Fivetran rechnet exakt nach seinem Preismodell ab. Die Frage ist, ob die Abrechnung pro Zeile die richtige Ökonomie für Ihre größten und bewegtesten Tabellen ist.
Wo die Kosten eigentlich hingehören
- Das Laden datenintensiver Tabellen ist eine Kernaufgabe des Data Warehouse. Eine modellgetriebene Plattform lädt sie als Teil der Warehouse Generierung, auf Compute, das Ihnen bereits gehört.
- Nur das Delta sollte weiter nach unten wandern. Eine automatisierte Data Vault Architektur lädt nur das, was sich geändert hat, in Hubs, Links und Satelliten. Ein Full Reload im Staging wird nicht zu einem Full Reload jeder Schicht darüber.
- Der Long-Tail kann auf dem Connector bleiben. Managed-Connectors sind stark bei SaaS Quellen mit geringem Volumen, wo MAR klein und vorhersehbar bleibt.
Was sich mit Datavault Builder ändert
Datavault Builder bringt seine eigene Ingestion mit: Batch, Delta und CDC Loads aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen, mit Streams wie Kafka, die als Micro-Batches ankommen, alles aus derselben Plattform, die auch den Rest des Warehouse generiert.
- Volumenstarke Tabellen werden von der zeilenbasierten Abrechnung entkoppelt. Sie landen über die Plattform im Staging, und die Connector-Rechnung hört auf, dem Projektkalender Ihres ERP-Teams zu folgen.
- Full Rebuilds bleiben auf das Staging beschränkt. Die generierten Vault-Loads vergleichen gegen das, was bereits historisiert ist, und bewegen nur das Delta. Ein Reload im Quellsystem ist also kein Reload überall.
- Auch Tabellen, die weiterhin über den Connector laufen, bleiben entkoppelt. Rohe Landing-Tabellen und die historisierte Schicht sind getrennt, die Wahl des Connectors pro Tabelle bleibt also Ihre und ist umkehrbar.
- Kosten werden wieder planbar und kalkulierbar. Warehouse Compute können Sie messen, reservieren und prognostizieren. Zeilenaktivität im System von jemand anderem nicht.
Was zu entscheiden ist
Analysieren Sie Ihren MAR-Report der letzten sechs Monate und sortieren Sie ihn nach Tabellen. Wenn die obersten fünf bis zehn Tabellen den Großteil der Kosten tragen, ist das die Liste, die auf direkte Ingestion umziehen sollte. Alles unterhalb der Linie kann genau so bleiben, wie es ist.
Erleben Sie es live mit Ihren eigenen Datenquellen
Buchen Sie eine kostenlose Demo und bringen Sie den Connector mit, der Sie am meisten kostet, an Geld oder an Zeit.
In drei Schritten zu einer Pipeline, die Sie kontrollieren
-
Die Tabellen finden, die ausschlagen
Meist tragen drei oder vier Quellen den Großteil der MAR. Große Faktentabellen, häufig aktualisierte Tabellen, alles, was migriert wurde.
-
Diese über die Plattform laden
Datavault Builder lädt sie per Batch, Delta oder CDC direkt ins Staging, aus Datenbanken, Dateien, APIs oder Streams. Keine Abrechnung pro Zeile auf dem Weg hinein.
-
Den Rest lassen, wo er ist
SaaS-Quellen aus dem Long-Tail können auf dem Connector bleiben. Der Vault entkoppelt sie von der Schicht, die Sie tatsächlich neu verarbeiten.
Wie Datavault Builder die Reibungsverluste in der Ingestion beseitigt
-
Ingestion ist eingebaut
Batch-, Delta- und CDC-Ladevorgänge aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen, mit Streams wie Kafka, die als Micro-Batches ankommen. Dieselbe Plattform, die das Warehouse generiert, keine zweite Rechnung.
-
Ihr Schema, nicht das des Anbieters
Quelltabellen werden auf ein Data-Vault-2.0-Modell gemappt, das Sie entworfen haben. Eine neue Spalte oder eine umbenannte Tabelle ändert ein Mapping, keine Kette von Skripten nach dem Load.
-
Nur Deltas bewegen sich
Hubs, Links und Satelliten laden, was sich geändert hat. Vollständige Ladevorgänge bleiben im Staging, statt jede Nacht weiter unten neu verarbeitet zu werden.
-
Historie wird von Haus aus behalten
Jede Änderung wird so festgehalten, wie sie eintrifft. Historien- und Stichtagsabfragen funktionieren also auch dort, wo die Quelle ihre eigenen Zeilen überschreibt.
-
Code, den Sie nie von Hand schreiben
Laden, Historisierung und Lineage werden in Echtzeit aus dem Modell generiert und laufen nativ auf Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle oder PostgreSQL.
-
Eine Plattform, bis zu neun Tools weniger
Modellierung, ETL, CI/CD, Dokumentation und Lineage an einem Ort. Das ist es, was 14,7 Minuten von der Anforderung bis zur Produktion möglich macht.
Ausgezeichnet von BARC im Data Fabric Survey 26







Sprechen Sie mit unserem Experten
Zwanzig Minuten mit unserem Sales Director und eine ehrliche Antwort, ob das zu Ihrem Stack passt.

Matt Collett
Sales Director
Perfekt, wählen Sie einen passenden Termin:
Weitere Probleme in dieser Serie
-
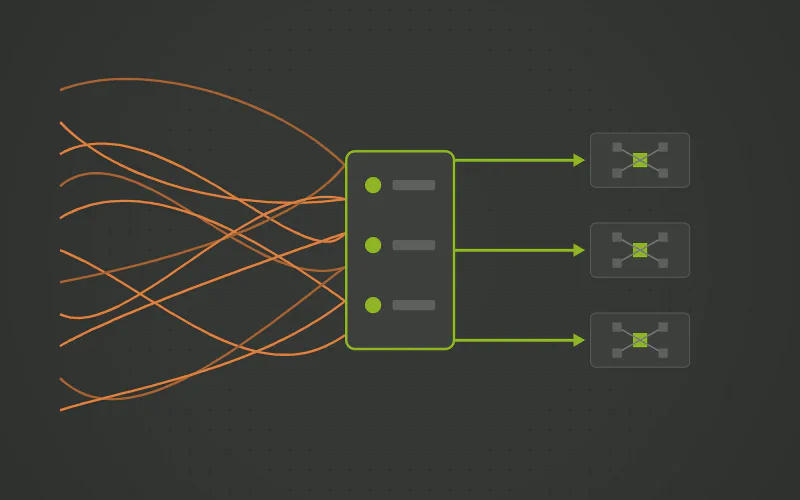
Unerwartete Fivetran-Kosten und Schema-Probleme? Wie automatisierte Modellierung die Reibungsverluste in der Ingestion beseitigt
Plug-and-Play-ELT ist schnell gestartet und schwer zu kontrollieren. Zwei Dinge erodieren mit der Zeit: was die Pipeline kostet, und wer über die Struktur der Daten entscheidet. Eine automatisierte Data Vault Schicht gibt beides zurück, ohne die Connectors aufzugeben, die funktionieren.
-
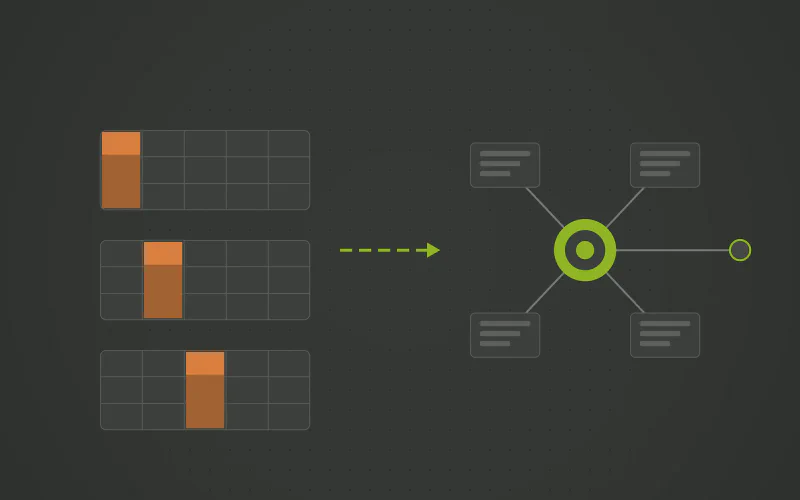
Zwingt Sie Ihr Fivetran-Schema, Ihr Datenmodell nach jedem Load neu aufzubauen?
Fivetran legt jede Quelle in ihrem eigenen standardisierten Schema ab. Business-Keys, eigene Felder und Legacy-Strukturen müssen danach in SQL umgeformt werden, das bricht, sobald sich der Connector ändert. Die Lösung ist kein besseres Skript, sondern ein Modell, das die Datenstruktur vorgibt.
Fragen und Antworten
- Nicht unbedingt. Viele Teams behalten den Connector für den Long-Tail der SaaS-Quellen und verlagern nur die teuren Tabellen mit hohem Volumen auf direkte Ingestion. Der Vault sitzt hinter beiden, dem Modell weiter unten ist es also egal, welchen Weg eine Tabelle genommen hat.
- Batch, Delta und CDC Loads aus Datenbanken über JDBC, aus Dateien und aus REST-APIs, dazu NoSQL Speicher über den Trino Connector und Python-Quellen über einen gRPC Connector. Streams wie Kafka kommen als Micro-Batches über Trino an. CDC ist Teil der Enterprise Stufe.
- Sie kosten Compute auf Ihrem eigenen Warehouse, das Sie ohnehin bezahlen und dimensionieren können. Was verschwindet, ist die Lizenzgebühr pro Zeile für Zeilen, die ein Quellsystem neu schreibt, und die erneute Verarbeitung unveränderter Zeilen weiter unten.