¿Problemas de coste y rigidez de esquema en Fivetran? La automatización del modelado es la respuesta
El ELT plug and play es rápido de iniciar y complejo de controlar a escala. Dos factores se degradan con el tiempo: el coste del pipeline y el control sobre la estructura de los datos. Una capa de Data Vault automatizada recupera ambos sin renunciar a los conectores existentes.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores









¿Le suena familiar?
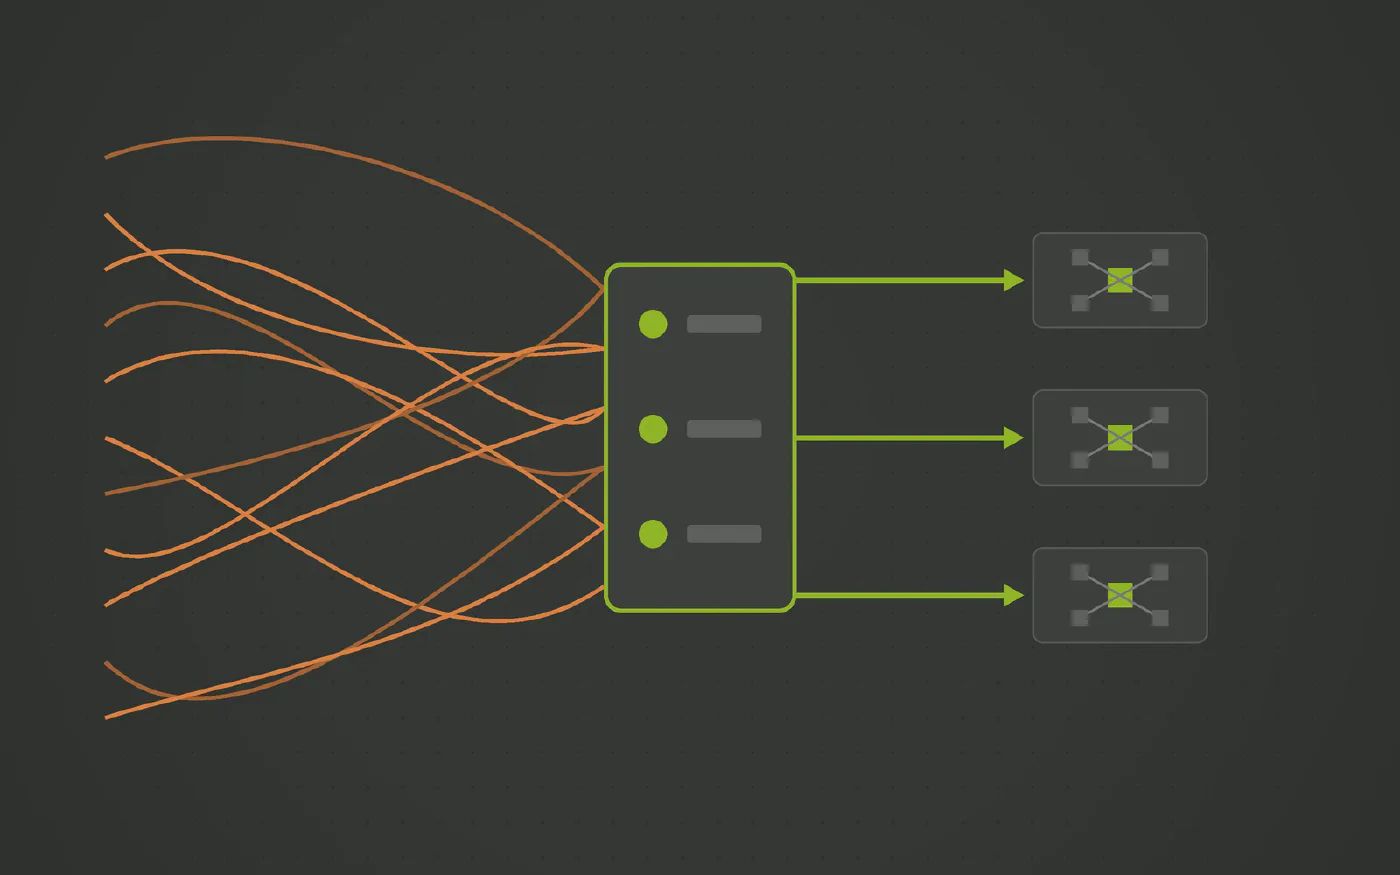
- La factura de Fivetran se disparó tras una migración o actualización masiva en el sistema de origen debido a la tarificación por Monthly Active Rows (MAR).
- El esquema predefinido por el conector obliga a escribir y mantener decenas de scripts SQL posteriores para adaptar las claves a la lógica del negocio.
- Cualquier ajuste en la estructura que realiza el conector gestionado amenaza con romper las vistas y los informes analíticos en producción.
- El equipo mantiene conectores gestionados para unas fuentes y scripts manuales para otras, sin una capa unificada de gobernanza.
Las herramientas de ingesta gestionada como Fivetran han transformado la forma en que los equipos de datos conectan orígenes SaaS. Prometen una experiencia plug and play: configurar credenciales y recibir tablas en el data warehouse en cuestión de minutos.
Esa comodidad inicial suele convertirse en una fuente de dolores de cabeza a medida que la arquitectura madura.
La contrapartida del ELT plug and play
El problema tiene dos caras:
- Facturación impredecible por Monthly Active Rows (MAR). Cada actualización en el origen y cada proceso de backfill incrementan el recuento de filas activas y elevan la factura mensual. Consulte el artículo sobre tarificación MAR.
- Esquemas rígidos y pérdida de control. Las tablas se cargan con la estructura que decide el proveedor. Adaptarlas al modelo de su empresa exige cadenas de scripts SQL posteriores mantenidos a mano. Consulte el artículo sobre esquemas rígidos.
El resultado es paradójico: lo que prometía eliminar la ingeniería de datos termina generando una capa masiva de scripts de transformación manuales y una factura de suscripción difícil de justificar ante la dirección financiera.
Dónde debe residir el control
La responsabilidad de gobernar el data warehouse no corresponde a la herramienta de transporte. Debe residir en una capa arquitectónica dedicada:
- Propiedad del esquema. El diseño de los datos debe responder a las necesidades estratégicas de su organización, no a las peculiaridades de la API de un conector externo.
- Historización garantizada. La preservación del histórico no puede depender de que el conector ofrezca tablas de historial propietarias; debe integrarse de forma estándar en el vault.
- Costes transparentes y gestionables. La computación se dimensiona en su propia base de datos, eliminando peajes variables por fila transportada.
Qué aporta Datavault Builder
Datavault Builder complementa o sustituye los conectores de ingesta ofreciendo una solución completa de modelado y automatización:
- Ingesta directa sin costes por fila. Cargue bases de datos relacionales, archivos, APIs y fuentes NoSQL directamente en su data warehouse con la misma plataforma que genera los modelos.
- Aislamiento frente a cambios. Las tablas de staging se mapean a un modelo Data Vault 2.0. Si un conector modifica un campo o altera una estructura, se ajusta el mapeo visual sin afectar a los marts de consumo.
- Modelado visual de negocio. Diseñe productos de datos, dimensiones y tablas de hechos mediante interfaces visuales intuitivas, con linaje y documentación generados automáticamente.
Recomendación práctica
Haga balance de los scripts manuales que su equipo ha tenido que programar exclusivamente para remodelar lo que entregan los conectores automáticos. Descubrirá que la mayor parte del esfuerzo sigue dedicándose a la fontanería de datos. Adoptar una solución guiada por modelos devuelve el foco a lo verdaderamente importante: la entrega de valor analítico.
Véalo funcionando con una de sus fuentes de datos
Reserve una demo gratuita y traiga el conector que más le cuesta, en dinero o en tiempo.
Tres pasos hacia un pipeline que usted controla
-
Identificar los factores de coste y rigidez
Distinga entre la comodidad de mover datos y sus dos costes: la pérdida de control sobre los esquemas y las tarifas variables por volumen.
-
Interponer una capa Data Vault
Cargue los datos en staging y mapéelos visualmente a hubs, links y satélites antes de entregarlos al negocio.
-
Ingestar directamente las fuentes de gran volumen
Utilice ingesta nativa integrada para tablas masivas o transaccionales, reservando conectores de pago solo para orígenes SaaS complejos.
Cómo Datavault Builder elimina las fricciones en la ingesta
-
La ingesta viene integrada
Cargas batch, delta y CDC desde bases de datos, archivos, APIs REST, fuentes NoSQL y Python, recibiendo flujos como Kafka en micro-batches. La misma plataforma que genera el warehouse, sin una segunda factura.
-
Su propio esquema, no el del proveedor
Las tablas de origen se mapean a un modelo Data Vault 2.0 diseñado por usted. Una nueva columna o una tabla renombrada modifica un mapeo, no una cadena de scripts post-carga.
-
Solo se mueven los deltas
Los hubs, links y satélites cargan lo que ha cambiado. Las recargas completas permanecen en staging en lugar de reprocesarse aguas abajo cada noche.
-
El historial se conserva por diseño
Cada cambio se retiene según llega, por lo que el reporting histórico funciona incluso cuando el origen sobrescribe sus propios registros.
-
Código que nunca tendrá que escribir a mano
La carga, historización y linaje se generan desde el modelo en tiempo real y se ejecutan de forma nativa en Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle o PostgreSQL.
-
Una plataforma, hasta nueve herramientas menos
Modelado, ETL, CI/CD, documentación y linaje en un solo lugar. Eso es lo que hace posible pasar del requerimiento a producción en 14,7 minutos.
Reconocido por BARC en The Data Fabric Survey 26







Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su arquitectura.

Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
¿Sigue limpiando a mano en SQL los esquemas que Fivetran carga de forma automática?
Fivetran carga cada fuente en un esquema predefinido por el proveedor. Las claves de negocio, los campos personalizados y las estructuras históricas deben remodelarse mediante SQL manual que se rompe cuando el conector cambia. La solución no es un script más elaborado, sino un modelo que gobierne la estructura.
-
¿Provocan las Monthly Active Rows (MAR) de Fivetran sustos en su presupuesto mensual?
Fivetran factura por Monthly Active Rows (MAR): filas insertadas o actualizadas en cada mes. Una actualización masiva en el origen, una migración o una recarga histórica multiplican el recuento y disparan la factura. La ingesta directa en el warehouse, unida a un vault que solo mueva deltas, mantiene los costes predecibles.
Preguntas y respuestas
- Las tablas que Fivetran ya deposita en su warehouse actúan inmediatamente como capa de staging para Datavault Builder. Conecte la herramienta al esquema de staging, asigne visualmente las tablas a hubs, links y satélites, y comience a generar las estructuras gobernadas sin interrumpir la extracción en curso.
- No necesariamente. Fivetran resulta muy práctico para cientos de aplicaciones SaaS secundarias con APIs complejas. La solución recomendada es desacoplar el almacén de datos de los esquemas del proveedor y asumir la ingesta directa de las bases de datos de alto volumen para evitar costes desmedidos por MAR.