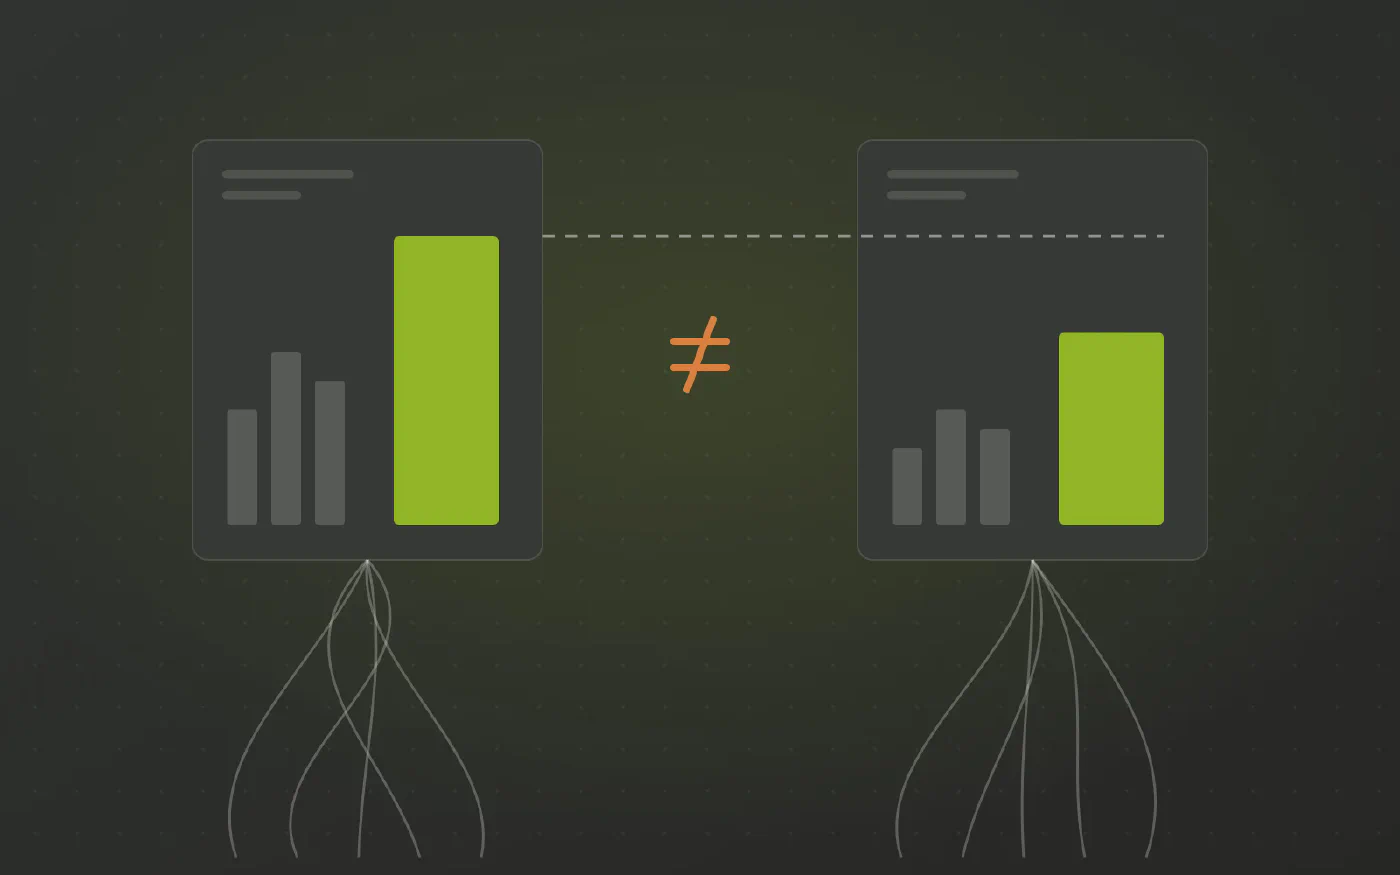
Ukazují vaše Qlik aplikace a Power BI reporty různá čísla?
Chybu nemá Qlik ani Power BI. Každý má vlastní logiku načítání, vlastní definice a vlastní lineage, takže se stejná metrika počítá dvakrát a nikdo je nedokáže sladit. Pravidla patří do jednoho spravovaného modelu v datovém skladu, ze kterého čtou oba nástroje.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory
Zní vám to povědomě?
- Qlik aplikace a Power BI report ukazují za stejný měsíc různé tržby.
- Každý tým věří svému nástroji a oba dokážou vysvětlit, jak jejich číslo vzniklo.
- Sladit je znamená číst načítací skript a Power Query vedle sebe.
- Vedení se ptá, které číslo je správné, a upřímná odpověď zní, že obě.
Když se dva BI nástroje neshodují, láká svalit vinu na jeden z nich. Obvykle oba spočítaly přesně to, co jim bylo zadáno. Jen jim bylo zadáno něco jiného.
Proč se čísla rozcházejí
- Každý nástroj má vlastní logiku. Qlik ji uplatňuje v načítacím skriptu, Power BI v Power Query a DAX.
- Definice vznikly dvakrát. Vratky, storna a měny se v každém nástroji řeší zvlášť a řeší je jiní lidé.
- Liší se načasování. Reload a refresh běží v jiný čas nad jinými extrakty.
- Lineage končí u nástroje. Ani jedna strana neumí té druhé ukázat, odkud se její číslo vzalo.
Ruční sladění obou opraví tento měsíc. Další změna pravidla je znovu rozdělí.
Proč to dopadá na vás
- Máte vysvětlit rozdíl, který vznikl rozhodnutími v nástroji jiného týmu.
- Odsouhlasování čísel je neviditelná práce. Všimne si jí někdo, až když čísla nesedí.
- Svou logiku v Qliku zdokumentovat můžete. Přimět Power BI model, aby se jí řídil, nemůžete.
Práce se dělá na špatném místě
- Definovat metriku je práce pro datový sklad. Když se dělá v každém BI nástroji zvlášť, vznikne jedna odpověď na každý nástroj.
- Patří na jedno centrální místo: do datového skladu nebo data hubu, který se postaví jednou a čte z něj každá aplikace.
- Pokud to zní draze, odhad nejspíš počítá s tím, že se datové pipeline budou stavět ručně. Specializovaná automatizační platforma je generuje z modelu, a to mění náklady i čas, který to zabere.
Co se změní, když model přijde hotový
Datavault Builder uloží byznys pravidla do datového skladu a vygeneruje dimenzionální vrstvu nativně v databázi, kterou už máte, od Fabric a SQL Server po Snowflake nebo BigQuery.
- Metrika se počítá jednou a Qlik i Power BI čtou stejné číslo.
- Oba nástroje načítají hotové tabulky, takže ani skript, ani model nenese vlastní definici.
- Pravidlo je vidět a je pod správou verzí, místo aby bylo rozdělené mezi
.qvfa.pbix. - Lineage ukazuje odvození, takže otázku vyřeší otevření grafu.
- Volba BI nástroje se stane věcí preference, ne toho, jaké číslo chcete vidět.
O co požádat
Ne “Power BI to má špatně”, ale:
“Qlik a Power BI počítají tržby oddělenou logikou, takže se neshodují a nedokážeme dohledat proč. Může definice žít jednou v datovém skladu, aby oba nástroje četly stejný spravovaný dimenzionální pohled?”
Tím se debata posune od toho, který nástroj má pravdu, k tomu, kde má definice žít.
Podívejte se, jak to funguje na vašich vlastních datech
Rezervujte si bezplatné demo a přineste report, se kterým máte největší potíže.
Tři kroky k číslům, která sedí
-
Vytáhněte stávající logiku
Posbírejte výpočty, joiny a filtry, které dnes žijí ve vašich reportech.
-
Centralizujte ji na jednom místě
Logika se jednou přesune do modelu datového skladu, takže každý report čte stejnou definici.
-
Čísla, která sedí
Každý report ukazuje stejné číslo a “odkud se tohle číslo vzalo” má viditelnou odpověď.
Jak Datavault Builder předá vašemu reportu hotový model
-
Model přijde hotový
Datavault Builder generuje vault a star schema tak, aby běžely nativně v databázi, kterou už máte: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks nebo BigQuery.
-
Práce opustí report
Žádný merge, žádné parsování, žádný fuzzy match. Tato práce z reportu zmizela.
-
Zdroje přicházejí integrované
Zákazníci z ERP, CRM a e-shopu se spárují do jedné sady konformních dimenzí. Join proběhne jednou v datovém skladu, ne znovu v každém reportu.
-
Historie, na kterou se lze dotázat
Každá změna se uchová tak, jak přijde, takže můžete reportovat stav tehdy i stav nyní, i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Každé číslo má lineage
Logika získá lineage, takže otázka “odkud se tohle číslo vzalo” má viditelnou odpověď.
-
Změny řešené výše v řetězci
Pomalu se měnící dimenze se řeší výše v řetězci jako vault satelity, místo aby se jen aproximovaly.
Oceněno společností BARC v The Data Fabric Survey 26
Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí do vaší situace.
Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Čistíte stejná data znovu v každém načítacím skriptu v Qliku?
Stejné mapovací loady, opravy textových řetězců a deduplikace se znovu píšou v každé aplikaci a každé vrstvě QVD a jejich kopie se rozcházejí. Čištění se opakuje v každém skriptu, protože ho žádná integrovaná vrstva datového skladu neudělá jednou.
-
Jsou vaše výrazy Set Analysis v Qliku příliš dlouhé a pomalé?
Set Analysis je přesný nástroj pro skutečná srovnání. Většina dlouhých výrazů ve vaší aplikaci tam je, protože model nikdy nedodal historii, příznaky ani jednu granularitu, takže je graf skládá znovu při každém výběru.
-
Vytvářejí vaše Qlik aplikace pořád syntetické klíče?
Syntetické klíče a cyklické reference jsou jen Qlik, který přesně asociuje to, co dostal. Vznikají, protože data přicházejí bez konformních dimenzí a skutečných klíčů, takže si je musí vymyslet každá aplikace.