Čistíte stejná data znovu v každém načítacím skriptu v Qliku?
Stejné mapovací loady, opravy textových řetězců a deduplikace se znovu píšou v každé aplikaci a každé vrstvě QVD a jejich kopie se rozcházejí. Čištění se opakuje v každém skriptu, protože ho žádná integrovaná vrstva datového skladu neudělá jednou.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory
Zní vám to povědomě?
- Stejná logika ApplyMap a Trim je v několika načítacích skriptech a kopie si už neodpovídají.
- Nový kód země ve zdroji znamená upravit mapovací tabulku v každé aplikaci, která ji používá.
- Dvě aplikace ukazují různý počet zákazníků, protože stejný zdroj deduplikují jinak.
- Nikdo si není jistý, který skript obsahuje aktuální verzi pravidla pro čištění.
Jedna aplikace, která čistí surová data, je obezlička. Deset aplikací, které čistí stejná surová data, každá trochu jinak, je druhý datový sklad, který nikdo nenavrhl.
Kde se stejné čištění píše znovu
- Každá aplikace kopíruje mapování. Stejný
MAPPING LOADaApplyMappro kódy zemí, produktů a zákazníků, vložený do každého skriptu, který dané pole potřebuje. - Každá kopie se odchyluje. Jeden skript ořezává mezery a převádí na velká písmena, druhý ne, třetí minulý měsíc přidal nový kód. Stejné pole, různé hodnoty.
- Každá vrstva QVD to opakuje. Extrakční a transformační aplikace i QVD generátory data čistí a další aplikace je pro jistotu vyčistí ještě jednou.
- Každá změna znamená hledání. Nový zdrojový kód je třeba najít a opravit v každém skriptu a ten, na který se zapomene, selže potichu.
Soubor $(Include) udrží text identický. Nezabrání ale tomu, aby každá aplikace sama rozhodla,
zda, kdy a v jakém pořadí ho použije.
Proč to dopadá na vás
- Každá aplikace vznikla, když byla potřeba, a zkopírovat opravy z posledního skriptu byla nejrychlejší cesta, jak ji dodat.
- Pravidlo nikdo nevlastní, takže si nikdo nevšimne, když se dva skripty začnou rozcházet.
- Skripty, které spravujete, sladit můžete. Zabránit zdroji, aby do všech posílal surová data, nemůžete.
Práce se dělá na špatném místě
- Čištění zdrojových dat je práce pro datový sklad. V Qliku se píše znovu v každém načítacím skriptu, který s daným polem pracuje.
- Patří na jedno centrální místo: do datového skladu nebo data hubu, který se postaví jednou a čte z něj každá aplikace.
- Pokud to zní draze, odhad nejspíš počítá s tím, že se datové pipeline budou stavět ručně. Specializovaná automatizační platforma je generuje z modelu, a to mění náklady i čas, který to zabere.
Co se změní, když model přijde hotový
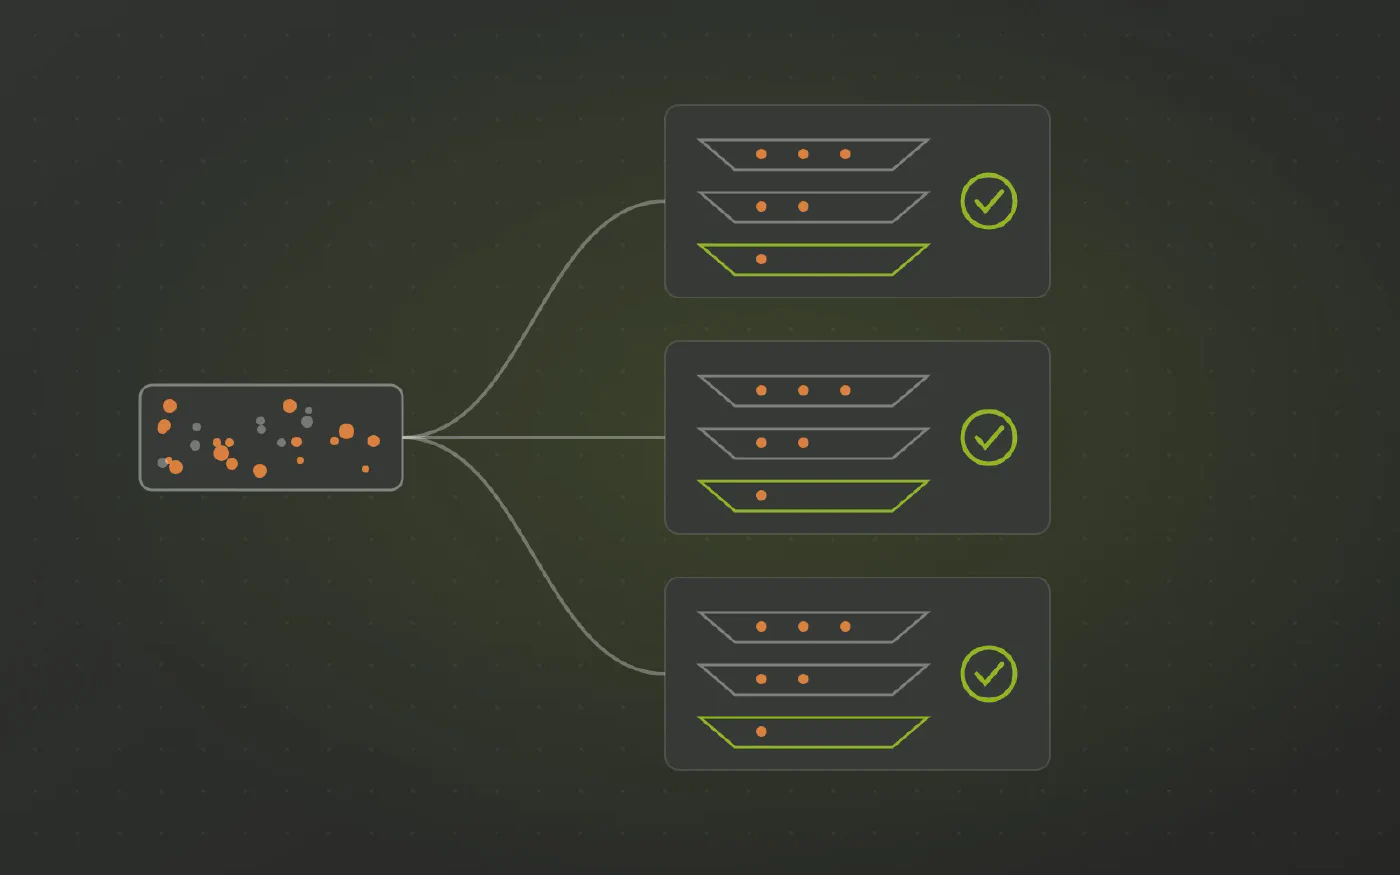
Datavault Builder generuje integrovaný, historizovaný vault a nad ním dimenzionální vrstvu, nativně v databázi, kterou už provozujete, od SQL Server a Azure SQL po Snowflake nebo BigQuery.
- Každé pravidlo pro čištění se definuje jednou, takže se mapování kódů mění na jednom místě, ne v každém skriptu.
- Duplicity se řeší při integraci, podle byznys klíčů, místo aby se filtrovaly v každé aplikaci zvlášť.
- Historie se uchovává jako satelity, takže žádné QVD nemusí držet včerejší verzi.
- Z načítacího skriptu se stane obyčejný
LOADz vyčištěných tabulek, dost krátký na to, aby se dal přečíst. - Lineage ukazuje každou transformaci, takže změněné pravidlo se dá dohledat dřív, než se nasadí.
O co požádat
Ne “transformační skript je jeden velký nepořádek”, ale:
“Stejná zdrojová pole čistíme a mapujeme v několika aplikacích typu QVD generátor a ty už se neshodují. Může toto čištění žít v integrované vrstvě datového skladu, aby naše aplikace načítaly hotové dimenze místo surových extraktů?”
Pokud postavení takové vrstvy zní jako rok práce na pipelinách, odhad počítá s tím, že se bude psát ručně. Právě tuto část Datavault Builder generuje.
Podívejte se, jak to funguje na vašich vlastních datech
Rezervujte si bezplatné demo a přineste report, se kterým máte největší potíže.
Tři kroky k číslům, která sedí
-
Vytáhněte stávající logiku
Posbírejte výpočty, joiny a filtry, které dnes žijí ve vašich reportech.
-
Centralizujte ji na jednom místě
Logika se jednou přesune do modelu datového skladu, takže každý report čte stejnou definici.
-
Čísla, která sedí
Každý report ukazuje stejné číslo a “odkud se tohle číslo vzalo” má viditelnou odpověď.
Jak Datavault Builder předá vašemu reportu hotový model
-
Model přijde hotový
Datavault Builder generuje vault a star schema tak, aby běžely nativně v databázi, kterou už máte: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks nebo BigQuery.
-
Práce opustí report
Žádný merge, žádné parsování, žádný fuzzy match. Tato práce z reportu zmizela.
-
Zdroje přicházejí integrované
Zákazníci z ERP, CRM a e-shopu se spárují do jedné sady konformních dimenzí. Join proběhne jednou v datovém skladu, ne znovu v každém reportu.
-
Historie, na kterou se lze dotázat
Každá změna se uchová tak, jak přijde, takže můžete reportovat stav tehdy i stav nyní, i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Každé číslo má lineage
Logika získá lineage, takže otázka “odkud se tohle číslo vzalo” má viditelnou odpověď.
-
Změny řešené výše v řetězci
Pomalu se měnící dimenze se řeší výše v řetězci jako vault satelity, místo aby se jen aproximovaly.
Oceněno společností BARC v The Data Fabric Survey 26
Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí do vaší situace.
Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Ukazují vaše Qlik aplikace a Power BI reporty různá čísla?
Chybu nemá Qlik ani Power BI. Každý má vlastní logiku načítání, vlastní definice a vlastní lineage, takže se stejná metrika počítá dvakrát a nikdo je nedokáže sladit. Pravidla patří do jednoho spravovaného modelu v datovém skladu, ze kterého čtou oba nástroje.
-
Jsou vaše výrazy Set Analysis v Qliku příliš dlouhé a pomalé?
Set Analysis je přesný nástroj pro skutečná srovnání. Většina dlouhých výrazů ve vaší aplikaci tam je, protože model nikdy nedodal historii, příznaky ani jednu granularitu, takže je graf skládá znovu při každém výběru.
-
Vytvářejí vaše Qlik aplikace pořád syntetické klíče?
Syntetické klíče a cyklické reference jsou jen Qlik, který přesně asociuje to, co dostal. Vznikají, protože data přicházejí bez konformních dimenzí a skutečných klíčů, takže si je musí vymyslet každá aplikace.