Selhává vám refresh extractů v Tableau, nebo nestíhá doběhnout?
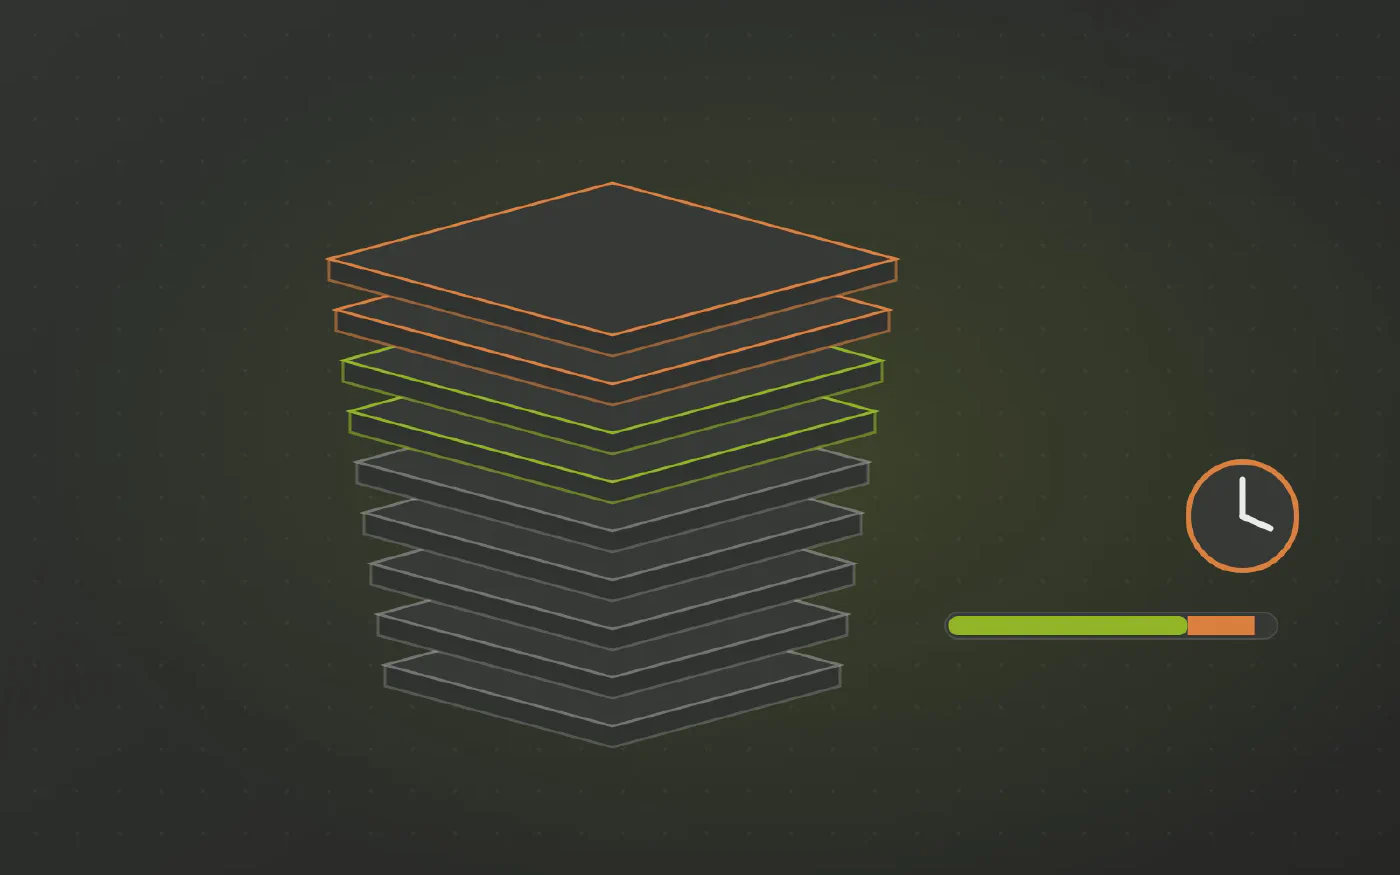
Backgrounder skončí timeoutem, soubor .hyper stále roste a dashboard ukazuje včerejšek. Extract je velký, protože nese surové řádky, které se výše v řetězci nikdy neagregovaly.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory
Zní vám to povědomě?
- Naplánovaný refresh na Tableau Cloud nebo Tableau Server selhává na timeout backgrounderu.
- Soubor .hyper narostl na desítky gigabajtů a s tím nikdo nepočítal.
- Refresh se přesune na 02:00, pak na 01:00, a stejně přetahuje do rána.
- Někdo se ptá, proč dashboard ukazuje včerejšek, a odpověď je složitá.
Extract by měl být rychlá kopie hotové tabulky. Když selže, obvykle je to proto, že hotovou tabulku nekopíruje, ale teprve ji staví.
Proč je extract tak velký
- Nese sloupce, které nikdo nepoužívá, protože bylo jednodušší vzít celou tabulku.
- Transformace probíhá při vytváření. Joiny, vypočítaná pole a blendy se řeší během sestavení extractu, a právě to vyčerpá backgrounder.
- Roste jen jedním směrem. Plný refresh rostoucího zdroje je každý měsíc pomalejší, dokud nepřekročí timeout.
Proč to dopadá na vás
- Optimalizovaný pohled, který jste potřebovali, nebyl k dispozici, takže se agregačním krokem stal extract.
- Kapacitu backgrounderu změnit nemůžete, a zdrojovou tabulku také ne.
- Dostanete upozornění, nebo hůř, dotaz na zastaralá data.
Práce se dělá na špatném místě
- Joinování a agregace jsou práce pro datový sklad. Uvnitř extractu se skládají znovu při každém refreshi.
- Patří na jedno centrální místo: do datového skladu nebo data hubu, který se postaví jednou a čte z něj každý workbook.
- Pokud to zní draze, odhad nejspíš počítá s tím, že se datové pipeline budou stavět ručně. Specializovaná automatizační platforma je generuje z modelu, a to mění náklady i čas, který to zabere.
Co se změní, když model přijde hotový
Datavault Builder postaví agregaci v datovém skladu a publikuje information marty, které Tableau může zkopírovat tak, jak jsou.
- Extract kopíruje, nepočítá. Doba vytváření výrazně klesne.
- Předagregované marty znamenají mnohem méně řádků a mnohem menší soubor
.hyper. - Inkrementální načítání probíhá výše v řetězci, v datovém skladu, kam patří.
- Refresh doběhne v rámci okna, a doběhne předvídatelně.
- S malým extractem je často znovu použitelné i živé připojení.
O co požádat
“Náš extract stahuje surové transakční řádky a joiny dělá při vytváření, proto backgrounder končí timeoutem. Můžeme v datovém skladu dostat agregovaný information mart, který bude extract jen kopírovat?”
Dost konkrétní na to, aby se to dalo naplánovat, a přesouvá práci tam, kde jsou data.
Podívejte se, jak to funguje na vašich vlastních datech
Rezervujte si bezplatné demo a přineste report, se kterým máte největší potíže.
Tři kroky k číslům, která sedí
-
Vytáhněte stávající logiku
Posbírejte výpočty, joiny a filtry, které dnes žijí ve vašich reportech.
-
Centralizujte ji na jednom místě
Logika se jednou přesune do modelu datového skladu, takže každý report čte stejnou definici.
-
Čísla, která sedí
Každý report ukazuje stejné číslo a “odkud se tohle číslo vzalo” má viditelnou odpověď.
Jak Datavault Builder předá vašemu reportu hotový model
-
Model přijde hotový
Datavault Builder generuje vault a star schema tak, aby běžely nativně v databázi, kterou už máte: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks nebo BigQuery.
-
Práce opustí report
Žádný merge, žádné parsování, žádný fuzzy match. Tato práce z reportu zmizela.
-
Zdroje přicházejí integrované
Zákazníci z ERP, CRM a e-shopu se spárují do jedné sady konformních dimenzí. Join proběhne jednou v datovém skladu, ne znovu v každém reportu.
-
Historie, na kterou se lze dotázat
Každá změna se uchová tak, jak přijde, takže můžete reportovat stav tehdy i stav nyní, i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Každé číslo má lineage
Logika získá lineage, takže otázka “odkud se tohle číslo vzalo” má viditelnou odpověď.
-
Změny řešené výše v řetězci
Pomalu se měnící dimenze se řeší výše v řetězci jako vault satelity, místo aby se jen aproximovaly.
Oceněno společností BARC v The Data Fabric Survey 26
Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí do vaší situace.
Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
Máte na Tableau Serveru příliš mnoho verzí stejného čísla?
Každý publikovaný .tdsx byl v den svého vzniku rozumný. Dohromady jsou to stovky soukromých definic stejné metriky a žádný způsob, jak poznat, která je správná.
-
Jsou vaše LOD výrazy v Tableau tak složité, že se jich bojíte dotknout?
FIXED, INCLUDE a EXCLUDE jsou přesné nástroje pro skutečné otázky nad více granularitami. Většina těch ve vašem workbooku tam je, protože datový sklad nikdy nevyřešil granularitu ani neuchoval historii.
-
Je váš Tableau dashboard pomalý při každé změně filtru?
Dvacet sekund “Executing Query” při každém kliknutí na filtr. Tableau nevykresluje pomalu. Čeká na databázi, která dostala otázku, na kterou nedokáže rychle odpovědět.