Vos actualisations d'extraits Tableau échouent-elles ou prennent-elles du retard ?
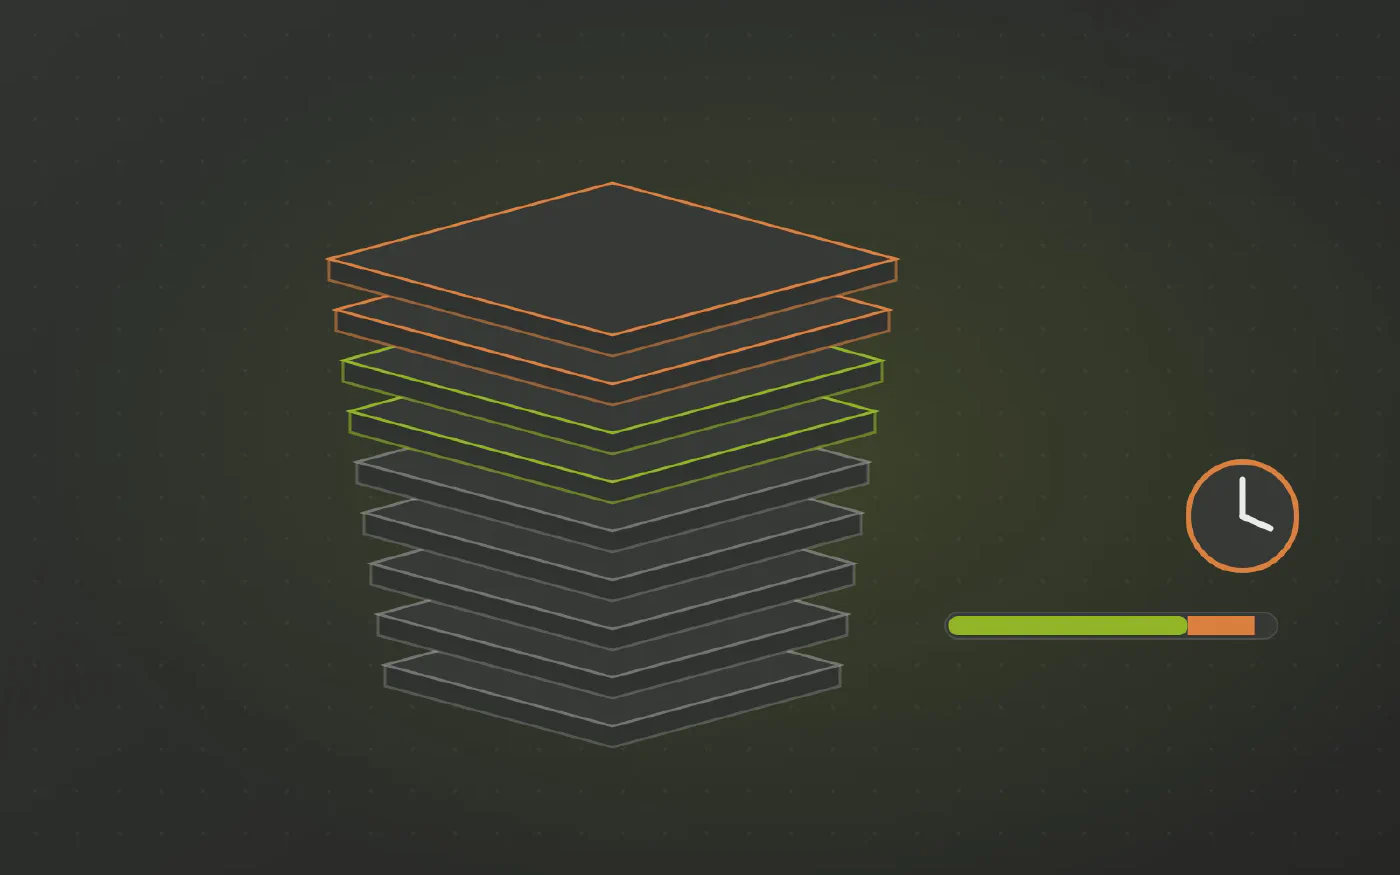
Le backgrounder expire, le fichier .hyper ne cesse de grossir, et le dashboard affiche les données de la veille. L'extrait est volumineux parce qu'il transporte des lignes brutes qui n'ont jamais été agrégées en amont.
La plateforme d'automatisation de data warehouse à laquelle font confiance les équipes data de tous les secteurs
Cela vous semble familier ?
- Les actualisations planifiées échouent sur Tableau Cloud ou Server avec un timeout du backgrounder.
- Le fichier .hyper atteint des dizaines de gigaoctets et personne ne l'avait prévu.
- Les actualisations sont déplacées à 02:00, puis à 01:00, et débordent encore sur la matinée.
- Quelqu'un demande pourquoi le dashboard affiche les données de la veille, et la réponse est compliquée.
Un extrait devrait être une copie rapide d’une table finie. Quand il échoue, c’est généralement parce qu’il ne copie pas une table finie, il en construit une.
Pourquoi l’extrait est si volumineux
- Il transporte des colonnes que personne n’utilise, parce qu’il était plus simple de prendre toute la table.
- La transformation a lieu pendant la création. Jointures, champs calculés et fusions de données sont résolus pendant la construction de l’extrait, et c’est ce qui épuise le backgrounder.
- Il ne fait que grossir. Une actualisation complète d’une source qui grandit est plus lente chaque mois, jusqu’à dépasser le timeout.
Pourquoi cela retombe sur vous
- La vue optimisée dont vous aviez besoin n’était pas disponible, alors l’extrait est devenu l’étape d’agrégation.
- La capacité du backgrounder ne dépend pas de vous, pas plus que la table source.
- C’est vous qui recevez l’alerte, ou pire, la question sur les données périmées.
Le travail se fait au mauvais endroit
- Joindre et agréger est un travail de warehouse. Dans l’extrait, il est refait à chaque actualisation.
- Ce travail a sa place dans un endroit central : un data warehouse ou un data hub, construit une fois et lu par chaque classeur.
- Si cela semble coûteux, l’estimation suppose probablement des pipelines construits à la main. Une plateforme d’automatisation spécialisée les génère à partir d’un modèle, ce qui change à la fois le coût et le délai.
Ce qui change quand le modèle arrive prêt à l’emploi
Datavault Builder construit l’agrégation dans le warehouse et publie des information marts que Tableau peut copier tels quels.
- L’extrait copie, il ne calcule pas. Le temps de création chute nettement.
- Des marts pré-agrégés signifient beaucoup moins de lignes et un fichier
.hyperbien plus petit. - Le chargement incrémental se fait en amont, dans le warehouse, là où il a sa place.
- Les actualisations se terminent dans la fenêtre prévue, et de manière prévisible.
- Avec un extrait léger, une connexion en direct redevient souvent envisageable.
Ce qu’il faut demander
« Notre extrait charge des lignes de transactions brutes et fait les jointures pendant la création, c’est pourquoi le backgrounder expire. Peut-on obtenir un information mart agrégé dans le warehouse, que l’extrait n’aurait plus qu’à copier ? »
Assez concret pour être chiffré, et cela déplace le travail là où se trouvent les données.
Voyez-le fonctionner sur vos propres données
Réservez une démo gratuite et apportez le rapport qui vous pose le plus de problèmes.
Trois étapes vers des chiffres qui concordent
-
Extraire la logique existante
Rassemblez les calculs, jointures et filtres qui vivent aujourd’hui dans vos rapports.
-
La centraliser en un seul endroit
La logique passe une seule fois dans le modèle du warehouse, et chaque rapport lit la même définition.
-
Des chiffres qui concordent
Chaque rapport affiche le même chiffre, et « d’où vient ce chiffre » a une réponse visible.
Comment Datavault Builder fournit à votre rapport un modèle prêt à l'emploi
-
Le modèle arrive prêt à l'emploi
Datavault Builder génère le vault et le schéma en étoile pour qu’ils s’exécutent nativement dans la base de données dont vous disposez déjà : SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks ou BigQuery.
-
Le travail quitte le rapport
Pas de fusion, pas de parsing, pas de correspondance approximative. Ce travail a disparu du rapport.
-
Les sources arrivent intégrées
Les clients de l’ERP, du CRM et de la boutique en ligne sont rapprochés en un seul ensemble de dimensions conformes. La jointure a lieu une fois dans le warehouse, et non à nouveau dans chaque rapport.
-
Un historique interrogeable
Chaque modification est conservée à son arrivée, vous pouvez donc produire des rapports sur l’état passé comme sur l’état actuel, même lorsque le système source écrase ses propres enregistrements.
-
Chaque chiffre a son lineage
La logique gagne un lineage, donc « d’où vient ce chiffre » a une réponse visible.
-
Évolutions gérées en amont
Les dimensions à évolution lente sont gérées en amont sous forme de satellites du vault, pas approximées.
Reconnu par BARC dans The Data Fabric Survey 26
Rencontrez notre expert
Vingt minutes avec notre Sales Director, et une réponse honnête sur l’adéquation avec votre situation.
Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Autres problèmes traités dans cette série
-
Votre Tableau Server contient-il trop de versions du même chiffre ?
Chaque .tdsx publié était raisonnable le jour de sa création. Ensemble, ils forment des centaines de définitions privées du même indicateur, sans aucun moyen de savoir laquelle est la bonne.
-
Vos expressions LOD Tableau sont-elles trop complexes pour y toucher ?
FIXED, INCLUDE et EXCLUDE sont des outils précis pour de véritables questions à plusieurs granularités. La plupart de celles de votre classeur sont là parce que le warehouse n’a jamais résolu la granularité ni conservé l’historique.
-
Votre dashboard Tableau est-il lent à chaque changement de filtre ?
Vingt secondes de « Exécution de la requête » à chaque clic sur un filtre. Tableau n’affiche pas lentement. Il attend une base de données à qui l’on a posé une question à laquelle elle ne peut pas répondre rapidement.