Uvažujete o přesunu svých balíčků SSIS do cloudu metodou lift-and-shift?
Starší projekty v SSIS s sebou nesou tři neduhy, které cloudový virtuální server nevyřeší: balíček pro každou tabulku, na který se nikdo neodvažuje sáhnout, nasazování mimo DevOps a architekturu svázanou s SQL Serverem. Azure-SSIS Integration Runtime přenáší všechny tři do cloudu beze změny. Model, který sklad generuje, je učiní zbytečnými.
Platforma pro automatizaci datových skladů, které důvěřují datové týmy napříč obory









Zní vám to povědomě?
- Plán modernizace datového skladu spočívá v pouhém přesunu existujících balíčků `.dtsx` do Azure-SSIS Integration Runtime v cloudu.
- Tým se obává, že skutečná modernizace by si vyžádala ruční přepisování stovek balíčků po dobu několika let.
- Stávající balíčky v cloudu nadále selhávají na paměťových limitech při zpracování rostoucích objemů dat.
- Vedení požaduje přechod na Snowflake nebo Microsoft Fabric, ale integrační vrstvu nelze přenést bez kompletního předělání.
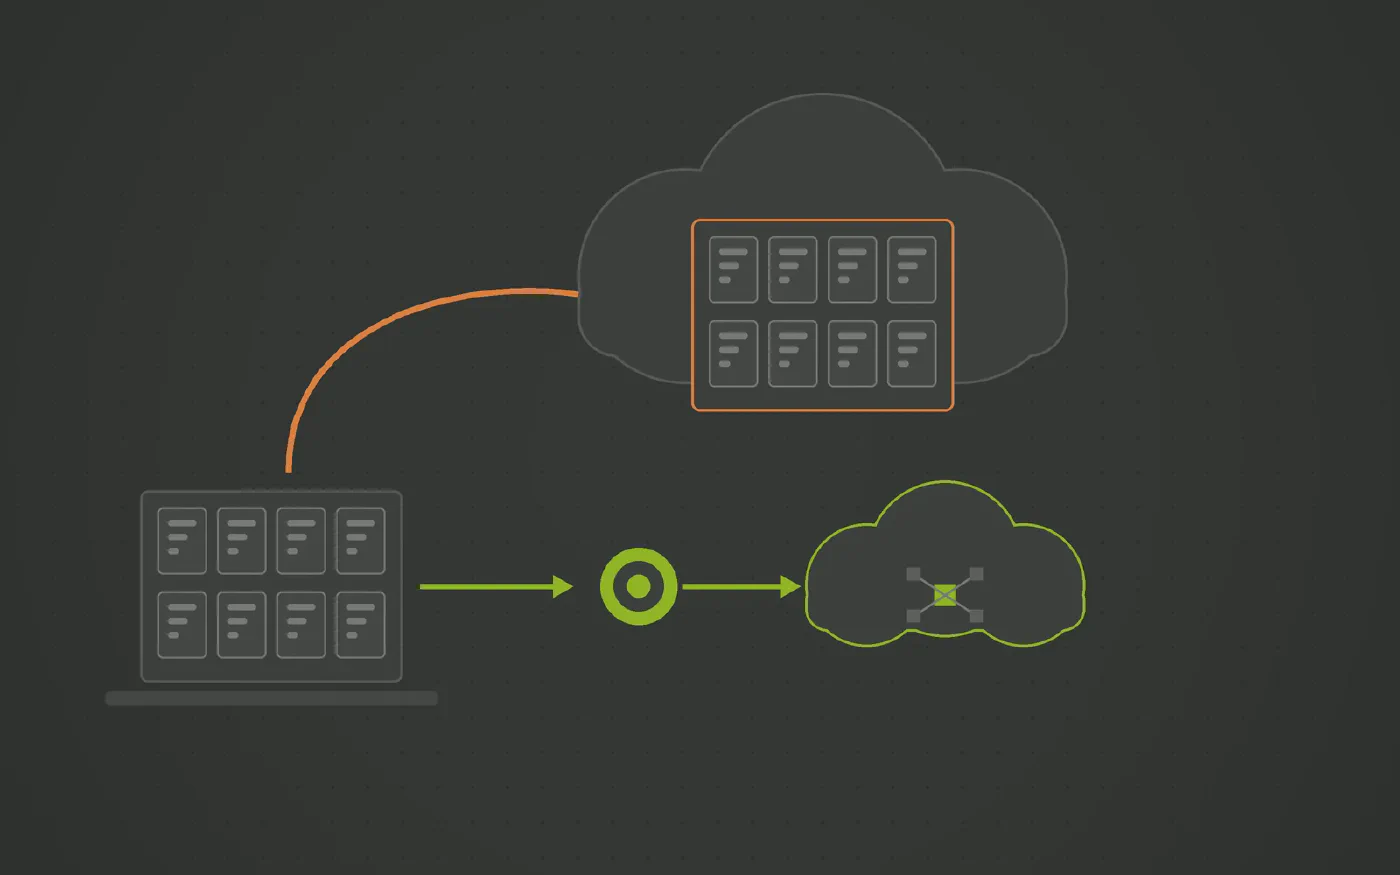
Při nutnosti opustit lokální datová centra nebo modernizovat zastaralou infrastrukturu volí mnoho organizací zdánlivě nejrychlejší cestu: lift-and-shift.
V případě SSIS to zpravidla znamená zřídit Azure-SSIS Integration Runtime v Azure Data Factory
a stávající balíčky .dtsx do něj nahrát tak, jak jsou.
Proč lift-and-shift problémy pouze stěhuje, ale neřeší
Rozsáhlý projekt v SSIS s sebou nese tři strukturální slabiny:
- Nahromaděný technický dluh. Stovky balíčků vytvořených různými konzultanty v průběhu mnoha let, s minimální dokumentací a skrytými vazbami. Přečtěte si článek o dluhu balíčků.
- Releases neslučitelné s CI/CD. Monolitické nasazování souborů
.ispaca ruční správa proměnných. Přečtěte si článek o nasazení a CI/CD. - Závislost na databázovém stroji SQL Serveru. Neschopnost efektivně využít moderní cloudové datové sklady, jako jsou Snowflake nebo Databricks. Přečtěte si článek o SSIS za hranicemi SQL Serveru.
Metoda lift-and-shift přenese všechny tři slabiny do cloudu v nezměněné podobě. Virtuální server v Azure je stále infrastrukturou, kterou musí někdo spravovat, licencovat a záplatovat. Technický dluh nezmizí tím, že změníte adresu serveru.
Skutečná modernizace: převést architekturu, nikoli technickou infrastrukturu
Ruční přepisování stovek balíčků do jiného ETL nástroje pouze přenáší starý dluh do nového prostředí. Pragmatický postup spočívá ve změně úrovně abstrakce:
- Vytěžit obchodní logiku. Skutečnou hodnotou vašich stávajících balíčků jsou pravidla extrakce, mapování zdrojových tabulek a definice analytických entit.
- Modelovat do Data Vaultu 2.0. Uspořádejte tuto logiku do struktury hubů, linků a satelitů.
- Generovat nový kód. Nechte automatizovanou platformu vygenerovat veškerý nativní ELT kód přímo pro vaši novou cloudovou databázi.
Přístup Datavault Builderu
Datavault Builder nabízí čistou a rychlejší cestu k modernizaci:
- Nativní cloudový běh. Generujte kód optimalizovaný přímo pro Microsoft Fabric, Snowflake, Databricks nebo Azure SQL.
- Nižší provozní náročnost. Žádné vyhrazené integrační servery, žádné paměťové limity a žádné zbytečné mezilehlé licence.
- Deterministické nasazování. Automatizované CI/CD, sémantická správa verzí v Gitu a generovaný rollback.
- Historizace bez ručního kódování. Správa časového vývoje dat je vyřešena jednotně pro celý datový sklad.
Podívejte se, jak to funguje na jednom z vašich zdrojů
Rezervujte si bezplatné demo a přineste konektor, který vás stojí nejvíce peněz nebo času.
Tři kroky k pipeline, kterou máte plně pod kontrolou
-
Pojmenovat tři slabiny SSIS
Přiznejte si technický dluh: model jednoho balíčku pro každou tabulku, absenci moderního DevOps a závislost na SQL Serveru.
-
Uznat, že lift-and-shift nemodernizuje
Přesun starého kódu na virtuální server v Azure ponechává veškeré náklady na údržbu a vývojová omezení nedotčené.
-
Migrovat model namísto technického kódu
Převeďte metadata ze stávajících balíčků do modelu Data Vault a nechte vygenerovat moderní kód pro novou cloudovou databázi.
Jak Datavault Builder odstraňuje třecí plochy při ingestu dat
-
Ingest dat je integrovaný
Dávkové, delta i CDC nahrávání z databází, souborů, REST API, NoSQL a Python zdrojů, přičemž proudy jako Kafka přicházejí v micro-batches. Stejná platforma, která generuje datový sklad, bez dalších faktur za licence.
-
Vaše schéma, nikoli schéma dodavatele
Zdrojové tabulky jsou namapovány na model Data Vault 2.0, který jste sami navrhli. Nový sloupec nebo přejmenovaná tabulka mění pouhé mapování, nikoli řetězec post-load skriptů.
-
Přenášejí se pouze delty
Huby, linky a satelity nahrávají jen to, co se skutečně změnilo. Plná přenačtení zůstávají ve stagingu, místo aby se každou noc přepočítávala v celém skladu.
-
Historie se uchovává automaticky návrhem
Každá změna je zachycena tak, jak dorazí, takže historický reporting funguje i tam, kde zdrojový systém přepisuje vlastní záznamy.
-
Kód, který nikdy nemusíte psát ručně
Nahrávání, historizace a lineage se generují z modelu v reálném čase a běží nativně na Snowflake, Databricks, BigQuery, SQL Serveru, Fabricu, Oracle nebo PostgreSQL.
-
Jedna platforma, až o devět nástrojů méně
Modelování, ETL, CI/CD, dokumentace a lineage na jednom místě. Právě to umožňuje přejít od zadání požadavku do produkce za 14,7 minuty.
Oceněno společností BARC v The Data Fabric Survey 26







Seznamte se s naším expertem
Dvacet minut s naším obchodním ředitelem a upřímná odpověď, zda se to hodí pro váš technologický stack.

Matt Collett
Sales Director
Skvělé, vyberte si vyhovující termín:
Další problémy, které tato série řeší
-
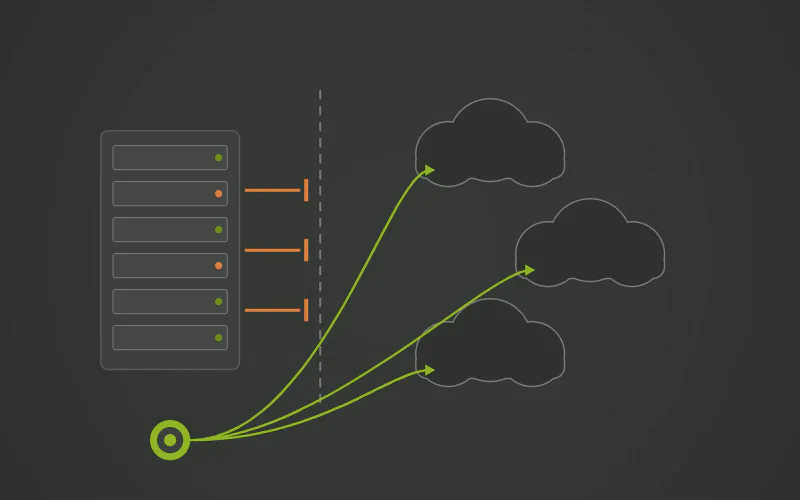
Provozujete stále SSIS na licencovaném SQL Serveru jen proto, abyste plnili Snowflake či cloud?
SQL Server Integration Services (SSIS) vznikly pro lokální ekosystém Microsoftu. Jejich použití pro plnění moderních cloudových skladů, jako jsou Snowflake, Databricks nebo Fabric, vyžaduje vyhrazené servery, konektory třetích stran a zbytečné licence pro SQL Server. Řešením je generovat nahrávání nativně přímo v cílovém databázovém stroji.
-
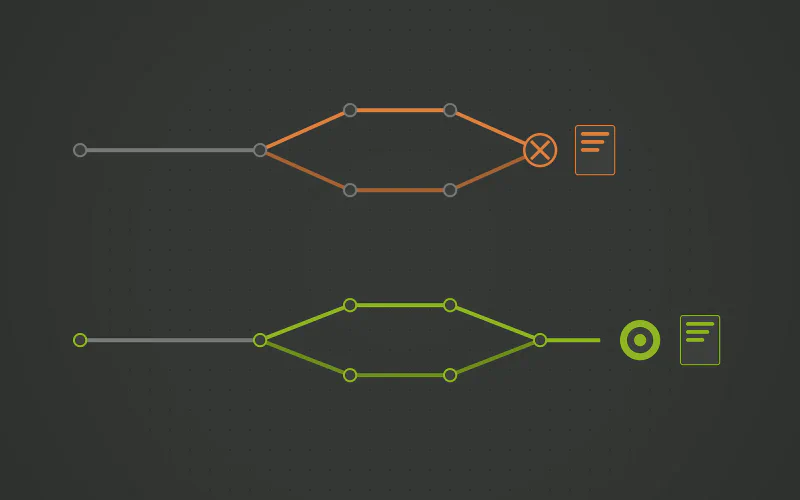
Je SSIS jedinou součástí vašeho technologického stacku, která stále nezvládá CI/CD?
Soubor .dtsx je kód XML, který se v Gitu špatně porovnává a ještě hůř slučuje; pokud dva inženýři upraví stejný balíček, obvykle to končí jeho ruční přestavbou. Prostředí závisejí na ručně udržovaných proměnných v SSISDB. Releases by měly vznikat z modelu, pro každé prostředí zvlášť, včetně rollbacku.
-
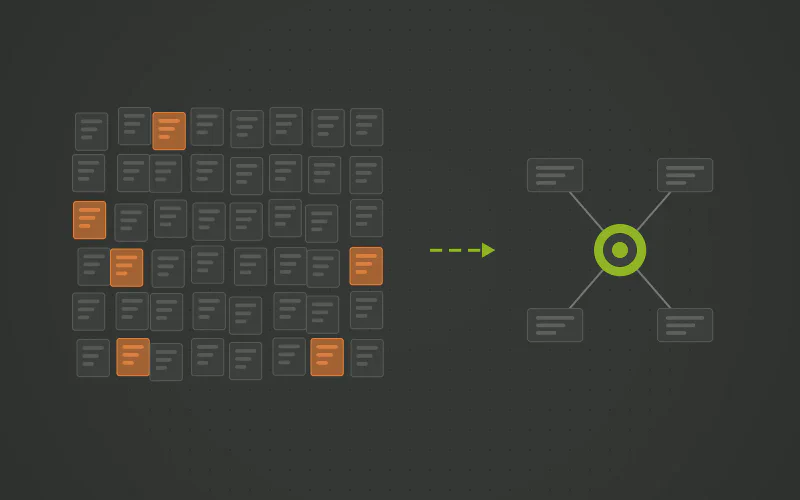
Převyšuje počet vašich balíčků SSIS počet lidí, kteří jim rozumí?
Stovky balíčků .dtsx, jeden pro každou tabulku, vytvořené ve Visual Studiu kýmkoli, kdo zrovna řešil daný úkol, s řídicími a datovými toky, jež se otevírají jen po jednom. Přidání sloupce znamená otevírat balíčky jeden po druhém. Řešením není šablona balíčku, ale model, který nahrávání generuje nativně pro SQL Server, Azure SQL nebo Fabric.
Otázky a odpovědi
- Nikoli. Argumentuje proti přesunu ručně postavených balíčků do Azure beze změny. Datový sklad generovaný Datavault Builderem běží nativně v Microsoft Fabricu, Azure SQL i Azure Synapse, stejně jako na lokálním SQL Serveru tak dlouho, jak je potřeba.
- Azure-SSIS Integration Runtime jako most a Fabric Data Factory jako cílová destinace. Most spouští balíčky tak, jak jsou. Cílová destinace je nové plátno, což znamená ruční přestavbu. Generování z modelu představuje třetí možnost a jedinou, při níž se balíčky postupně vyřazují, namísto jejich pouhého přemisťování či překreslování.
- Při přístupu řízeném modelem jde o mapování jednotlivých zdrojů namísto přepisování balíček po balíčku, přičemž staré balíčky běží dál, dokud není zdroj namapován. Žádné konkrétní číslo není poctivé bez znalosti rozsahu stávajícího řešení; mění se samotná povaha práce.