¿Su informe DirectQuery de Power BI va lento con cada clic?
DirectQuery y Direct Lake prometen datos en vivo. Lo que obtiene es un objeto visual de treinta segundos y una factura de cómputo que nadie quiere explicar. El modo no es el problema. El esquema que tiene debajo sí lo es.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores
¿Le suena familiar?
- Cada clic en un filtro lanza una nueva oleada de consultas y los objetos visuales se arrastran.
- Los costes de cómputo de Synapse o Fabric se dispararon el mes en que el dashboard salió a producción.
- Direct Lake vuelve a DirectQuery y nadie sabe explicarle exactamente por qué.
- El mismo informe es rápido en modo import, así que usa import y pierde los datos en vivo.
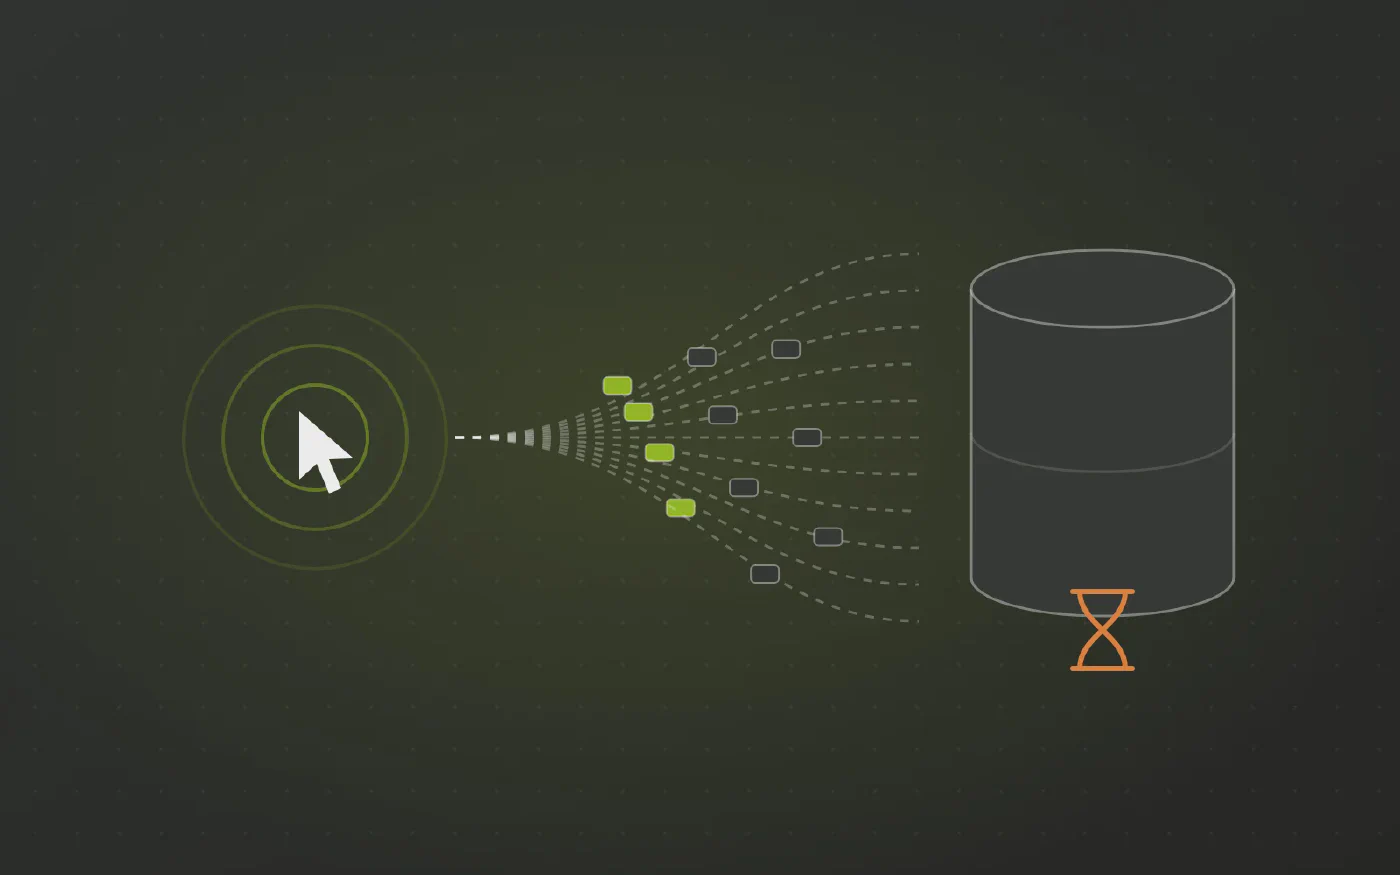
DirectQuery hace exactamente lo que dice: convierte cada interacción en SQL contra su base de datos. Que sea rápido depende por completo de sobre qué aterriza esa consulta.
Qué genera DirectQuery
- Contra un star schema: una tabla de hechos y unos pocos joins con dimensiones sobre claves reales. La base de datos responde en milisegundos.
- Contra tablas en 3NF o tablas en bruto del lake: joins anidados y profundos entre una docena de tablas, reconstruidos para cada objeto visual y cada clic.
- Sin push down en el que apoyarse. Tablas sin particionar y sin índices implican un escaneo completo cada vez.
- El fallback es silencioso. Direct Lake vuelve discretamente a DirectQuery cuando el origen no tiene la forma que necesita, y ahí es cuando aparece el coste.
Multiplíquelo por los objetos visuales de la página y luego por los usuarios concurrentes. Esa es la factura.
Por qué le toca a usted
- El warehouse expuso lo que tenía, que son tablas operativas, no analíticas.
- El modo import es la solución provisional, y le cuesta los datos en vivo por los que eligió DirectQuery.
- Puede optimizar los objetos visuales. No puede volver a particionar el origen.
El trabajo está en el lugar equivocado
- Dar a las tablas forma para el análisis es trabajo del data warehouse. DirectQuery no puede hacerlo, así que cada clic paga por la forma que falta.
- Debe hacerse en un único lugar central: un data warehouse o un data hub, construido una vez y leído por todos los informes.
- Si eso le parece caro, probablemente la estimación parte de pipelines construidos a mano. Una plataforma de automatización especializada los genera a partir de un modelo, lo que cambia tanto el coste como el tiempo necesario.
Qué cambia cuando el modelo llega terminado
Datavault Builder genera modelos dimensionales de forma nativa en la plataforma de destino, materializados o virtualizados, pensados para el push down analítico y no para el acceso transaccional.
- Una tabla de hechos, dimensiones reales. El SQL generado es corto por construcción.
- Particionado y agrupado por las columnas por las que la gente realmente filtra.
- Direct Lake se queda en Direct Lake, porque las tablas ya tienen la forma que necesita.
- El cómputo baja porque cada clic escanea un modelo ligero en lugar de la capa en bruto.
- Los datos en vivo dejan de ser un sacrificio a cambio de velocidad.
Qué pedir
“DirectQuery hace joins entre tablas normalizadas con cada clic, así que el coste de cómputo crece con el número de usuarios. ¿Podemos exponer un star schema particionado para que este informe lo consulte en su lugar?”
Lo bastante concreto para dimensionarlo, y señala la capa donde corresponde la solución.
Véalo funcionando con sus propios datos
Reserve una demo gratuita y traiga el informe que más problemas le da.
Tres pasos hacia cifras que cuadran
-
Extraer la lógica existente
Reúna los cálculos, joins y filtros que hoy viven en sus informes.
-
Centralizarla en un solo lugar
La lógica pasa una sola vez al modelo del warehouse, y todos los informes leen la misma definición.
-
Cifras que cuadran
Todos los informes muestran la misma cifra, y “de dónde sale esta cifra” tiene una respuesta visible.
Cómo Datavault Builder entrega a su informe un modelo terminado
-
El modelo llega terminado
Datavault Builder genera el vault y el star schema para que se ejecuten de forma nativa en la base de datos que ya tiene: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks o BigQuery.
-
El trabajo sale del informe
Sin merge, sin parsing, sin fuzzy match. Ese trabajo desaparece del informe.
-
Las fuentes llegan integradas
Los clientes del ERP, el CRM y la tienda online se consolidan en un único conjunto de dimensiones conformadas. El join se hace una vez en el warehouse, no de nuevo en cada informe.
-
Historial que puede consultar
Cada cambio se conserva tal como llega, así que puede analizar tanto cómo era como cómo es, incluso cuando el sistema de origen sobrescribe sus propios registros.
-
Cada cifra tiene lineage
La lógica gana lineage, así que “de dónde sale esta cifra” tiene una respuesta visible.
-
Cambios gestionados en el origen
Las dimensiones de cambio lento se gestionan en el origen como satélites del vault, no por aproximación.
Caso de éxito: Porta
Reconocido por BARC en The Data Fabric Survey 26
Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su situación.
Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
¿Sus informes de Power BI muestran cifras distintas para lo mismo?
Finanzas, Ventas y Operaciones construyeron cada uno su propio modelo semántico, y cada uno es coherente en sí mismo. Las definiciones nunca fueron erróneas en un lugar. Nunca se acordaron en ninguno.
-
¿Su DAX de Power BI se está volviendo demasiado largo para mantenerlo?
Doscientas líneas de CALCULATE y FILTER no son señal de un DAX avanzado. Normalmente son señal de que el warehouse nunca le dio las claves, el historial o la granularidad que necesitaba.
-
¿Su actualización de Power BI falla cada noche?
La actualización programada agota el tiempo de espera, Power Query se queda sin memoria y usted se entera cuando alguien abre el dashboard. La causa casi nunca es Power BI. Es lo que se le pide a Power BI que haga.