Vos packages SSIS sont-ils plus nombreux que les gens capables de les comprendre ?
Des centaines de packages .dtsx, un par table, construits dans Visual Studio par celui qui avait le ticket, avec des control flows et des data flows qui ne s'ouvrent qu'un à la fois. Ajouter une colonne revient à ouvrir les packages un par un. La solution n'est pas un modèle de package. C'est un modèle qui génère les chargements, nativement sur SQL Server, Azure SQL ou Fabric.
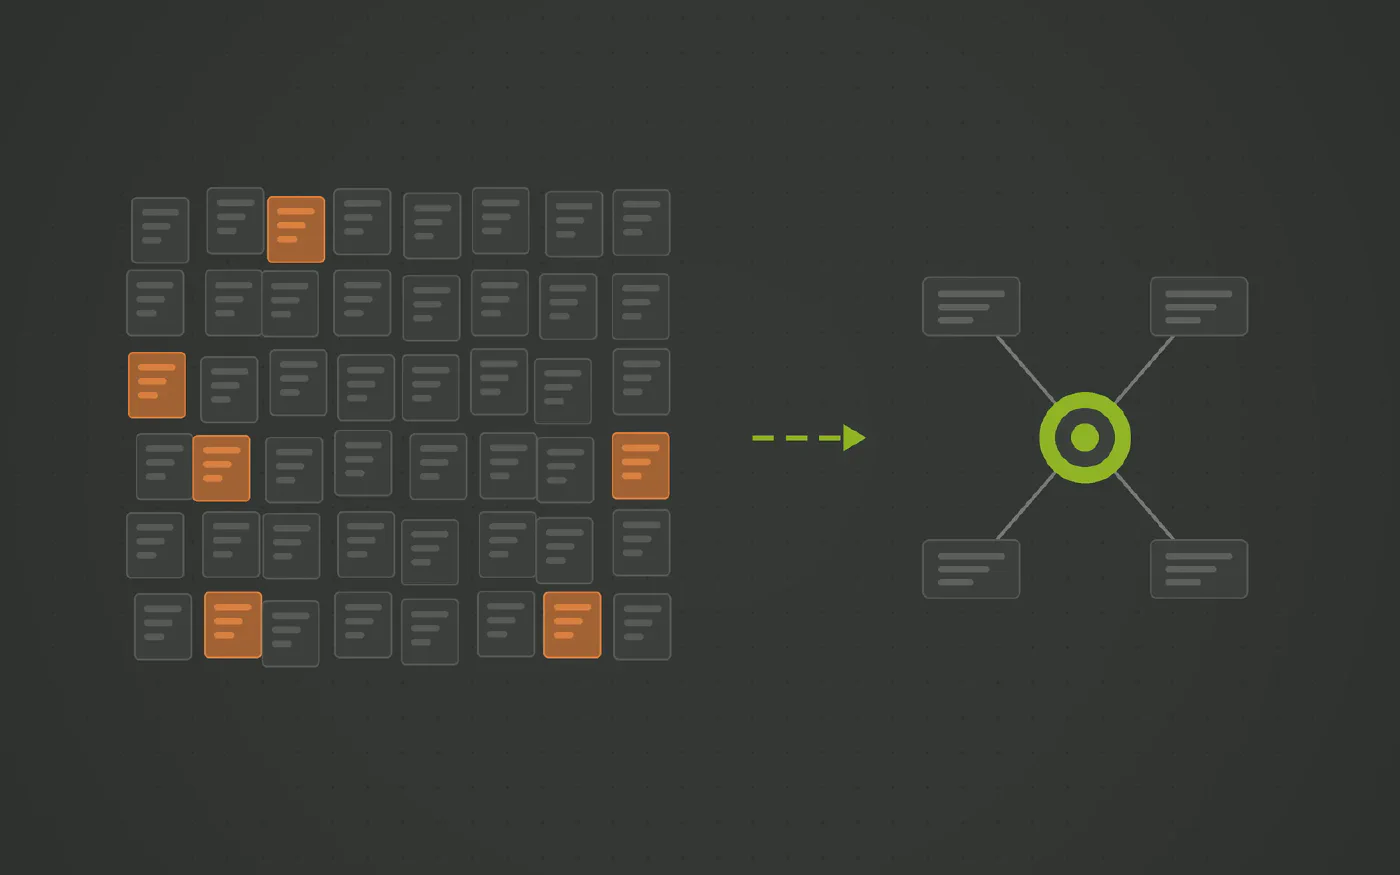
La plateforme d'automatisation de data warehouse à laquelle les équipes data font confiance









Cela vous semble familier ?
- Une nouvelle colonne source oblige à ouvrir chaque package qui touche la table, dans Visual Studio, un par un.
- Il y a un package par table, et ceux construits avant l'arrivée des paramètres de projet portent encore leurs propres chaînes de connexion.
- Personne ne sait avec certitude quels packages sont encore planifiés, et personne n'en supprime pour le découvrir.
- Ajouter des colonnes d'audit à l'entrepôt a été estimé en semaines, parce que c'est la même modification dans des centaines de data flows.
SSIS a été la bonne réponse pendant deux décennies d’entrepôts SQL Server, et un parc mature le montre : des centaines de packages, construits par de nombreuses mains au fil des années, qui s’ouvrent un à la fois dans Visual Studio. Les packages tournent toujours. Ce sont les modifications qui posent problème.
Pourquoi le parc est difficile à faire évoluer
- Un package par table, chacun construit à la main. Le même control flow et le même data flow, reconstruits pour chaque source, dans le style de celui qui avait le ticket cette semaine-là.
- Les packages anciens portent leur propre configuration. Les paramètres de projet et les connection managers partagés existent depuis 2012 ; les packages hérités construits avant, ou sans eux, contiennent encore des chaînes de connexion et des chemins en dur.
- Un changement de schéma est une tournée des packages. Ajouter une colonne à l’entrepôt oblige à ouvrir chaque package qui la touche. L’estimation se compte en semaines parce que la modification se trouve dans des centaines de data flows.
- Une colonne élargie casse un data flow. Les métadonnées d’un data flow sont typées et figées au moment de la conception, donc une colonne source qui grandit ou change de type met le composant en échec jusqu’à ce que quelqu’un la remappe dans Visual Studio.
- Personne ne sait ce qui est en production. Les packages sont planifiés depuis SQL Agent, depuis SSISDB, depuis d’autres packages, et personne ne veut être celui qui a supprimé le mauvais.
Rien de tout cela n’est la faute de SSIS. Un package est une bonne façon de construire un chargement et une mauvaise façon de décrire un entrepôt.
Où la structure devrait se situer
- Dans un modèle, pas dans des packages. Les clés métier, les relations et les attributs déclarés une seule fois, avec les chargements qui en dérivent.
- Générée, pour que chaque chargement ait la même structure. Pas de style propre à chaque développeur, pas de package que seul son auteur sait lire.
- Sur la plateforme que vous exploitez déjà. SQL Server et Azure SQL sont des cibles de premier rang, et Fabric est là quand le moment de bouger arrive.
Ce qui change avec Datavault Builder
Datavault Builder décrit l’entrepôt dans un modèle visuel et en génère les chargements de staging, d’historisation et de livraison, nativement pour SQL Server, Azure SQL et Fabric.
- Le package par table disparaît. Les hubs, les links, les satellites et leurs chargements sont générés à partir du modèle. Il n’y a plus rien à ouvrir dans Visual Studio.
- Une colonne est un changement de mapping. Mappez-la, régénérez, et chaque structure dépendante est mise à jour de façon cohérente. Les colonnes manquantes se chargent à null avec un avertissement ; les colonnes qui grandissent sont élargies.
- Chaque chargement a la même structure. C’est le générateur qui les écrit, donc il n’y a pas de dérive de style et aucun package que seul son auteur comprend.
- Le modèle est l’inventaire. Ce qui est chargé, depuis où, vers quoi, avec le lineage, est visible en un seul endroit. Plus besoin de fouiller dans les jobs SQL Agent.
- Rien n’a besoin de quitter SQL Server. L’entrepôt généré tourne là où tournaient les packages, et passe à Fabric par un simple changement de cible le jour où vous le décidez.
Ce qu’il faut décider
Auditez le parc et comptez les packages qui n’existent que pour charger une table depuis une source vers le staging ou l’entrepôt. Ce nombre donne la taille de la couche qu’un modèle devrait générer. Triée par source, cette même liste indique dans quel ordre retirer les packages.
Voyez-le fonctionner sur l'une de vos sources
Réservez une démo gratuite et apportez le connecteur qui vous coûte le plus cher, en argent ou en temps.
Trois étapes vers un pipeline que vous maîtrisez
-
Compter les packages qui ne font que charger une table
L’essentiel d’un parc SSIS mature est un package par table source faisant la même chose. C’est de la structure, pas de la logique.
-
Modéliser les sources à la place
Les clés métier, les relations et les attributs vont dans le modèle Datavault Builder. Les chargements sont générés, nativement sur SQL Server, Azure SQL ou Fabric.
-
Retirer les packages au fil des mappings
Chaque source mappée dans le modèle est un package qu’il n’y a plus besoin d’ouvrir. Le parc se réduit à mesure que le modèle grandit.
Comment Datavault Builder supprime les frictions de l'ingestion
-
L'ingestion est intégrée
Chargements batch, delta et CDC depuis les bases de données, les fichiers, les API REST, les sources NoSQL et Python, les flux comme Kafka arrivant en micro-batches. La même plateforme qui génère le warehouse, sans seconde facture.
-
Votre schéma, pas celui du fournisseur
Les tables source sont mappées vers un modèle Data Vault 2.0 que vous avez conçu. Une nouvelle colonne ou une table renommée change un mapping, pas une chaîne de scripts post-chargement.
-
Seuls les deltas circulent
Les Hubs, Links et Satellites chargent ce qui a changé. Les rechargements complets restent en staging au lieu d’être retraités en aval chaque nuit.
-
L'historique est conservé par conception
Chaque changement est conservé tel qu’il arrive, donc le reporting historique fonctionne même là où la source écrase ses propres lignes.
-
Du code que vous n'écrivez jamais
Le chargement, l’historisation et la traçabilité sont générés depuis le modèle en temps réel et s’exécutent nativement sur Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle ou PostgreSQL.
-
Une plateforme, jusqu'à neuf outils en moins
Modélisation, ETL, CI/CD, documentation et traçabilité au même endroit. C’est ce qui rend possible les 14,7 minutes entre le besoin et la production.
Reconnu par BARC dans The Data Fabric Survey 26







Rencontrez notre expert
Vingt minutes avec notre Sales Director et une réponse honnête sur l’adéquation avec votre stack.

Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Les autres problèmes traités par cette série
-
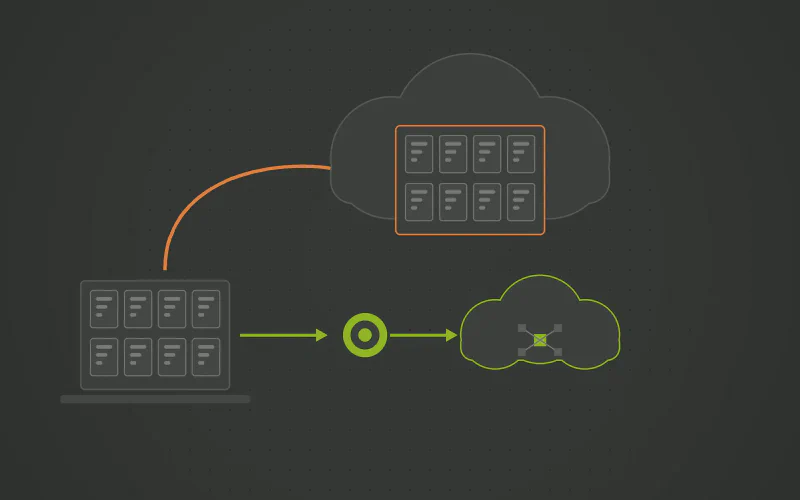
Les limites de SSIS : porter les packages dans le cloud déplace la dette, pas le problème
Les parcs SSIS ont trois problèmes qu’une VM dans le cloud ne résout pas : un package par table que personne ne veut ouvrir, des releases que le DevOps n’atteint pas, et une conception qui s’arrête à SQL Server. L’Azure-SSIS Integration Runtime emmène les trois dans Azure intacts. Un modèle qui génère l’entrepôt les supprime à la place.
-
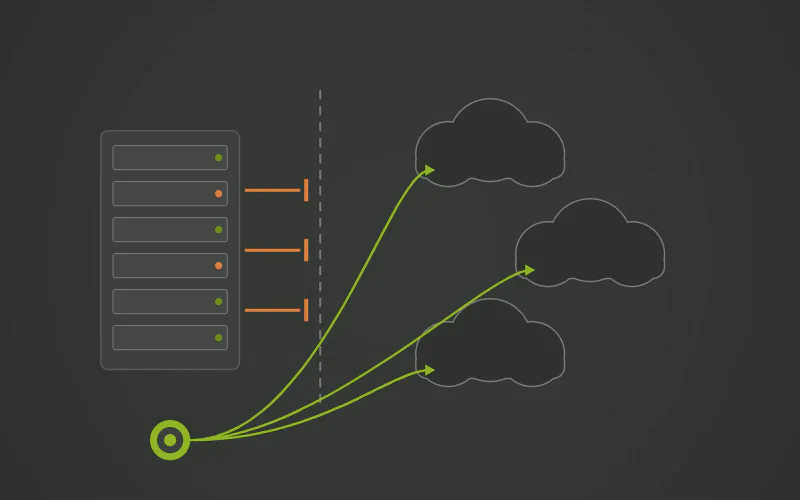
SSIS s'arrête-t-il là où commence votre entrepôt dans le cloud ?
SSIS a été conçu pour déplacer des données entre instances SQL Server on premises. Quand l’entrepôt part vers Fabric, Snowflake, Databricks ou BigQuery, les options sont de porter les packages sur un Azure-SSIS Integration Runtime, d’acheter des connecteurs tiers, ou de réécrire. Un modèle qui génère nativement pour la nouvelle plateforme est la quatrième option, et la seule qui n’emmène pas les packages avec elle.
-
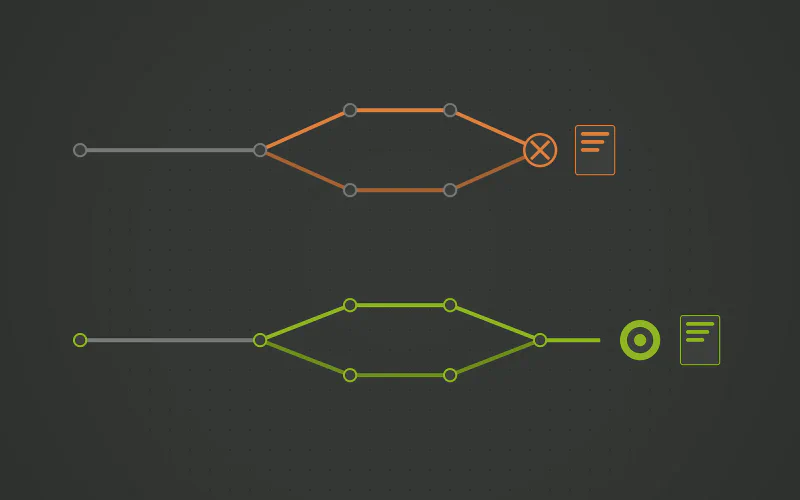
SSIS est-il la seule partie de votre stack encore incapable de faire du CI/CD ?
Un fichier .dtsx est du XML qui se compare mal et se merge encore plus mal, si bien que deux ingénieurs sur un même package finissent par tout refaire. Les environnements résident dans des mappings de variables SSISDB maintenus à la main. Le DevOps moderne s’arrête au projet SSIS. Les releases devraient être générées à partir d’un modèle, par environnement, rollback inclus.
Questions et réponses
- Non. Datavault Builder génère l’entrepôt nativement pour SQL Server et Azure SQL, et pour Fabric le jour où vous y allez. L’ETL se modernise sans que la plateforme ait à le faire.
- Cela supprime le travail manuel, et c’est un vrai progrès. Ce qui reste, c’est le parc : BIML produit des packages .dtsx, donc il y en a toujours des centaines à déployer, planifier, merger et exécuter sur un serveur SSIS. La différence, c’est de générer à partir d’un modèle des chargements ensemblistes qui s’exécutent dans la base, si bien qu’il n’y a plus aucun package.
- Ils continuent de tourner jusqu’à ce que leur source soit mappée dans le modèle, puis ils sont retirés. Il n’y a pas de bascule brutale ; le parc se réduit un mapping à la fois.
- Les règles métier passent dans le Business Vault, où elles sont versionnées et visibles dans le modèle. La logique de chargement, qui représente l’essentiel d’un package typique, est générée et ne s’écrit plus jamais.