Ist Ihr Azure Data Factory Canvas dem Team entwachsen, das ihn aufgebaut hat?
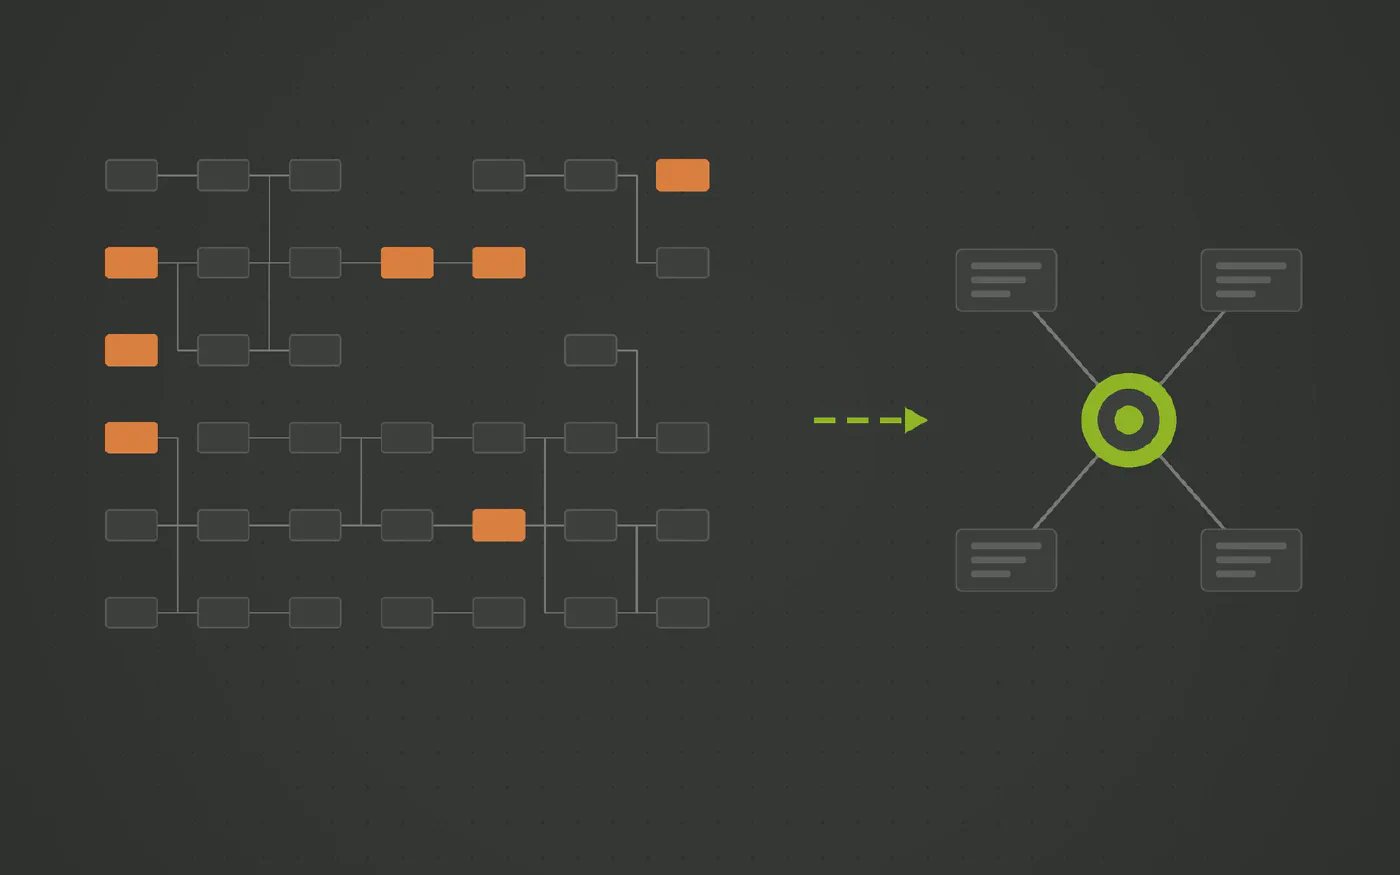
Eine Drag-and-Drop-Pipeline ist schnell zusammengeklickt, aber nur langsam anzupassen. Ab ein paar Dutzend Aktivitäten wird das Canvas zur Dokumentation, die visuelle Verdrahtung ersetzt die Fachlogik, und jede neue Quelle ist eine weitere Copy-Aktivität, die niemand anfassen will. Die Lösung ist kein aufgeräumterer Canvas. Es ist ein Modell, das die Pipelines generiert.
Die Data-Warehouse-Automationsplattform, der Datenteams aus vielen Branchen vertrauen









Kommt Ihnen das bekannt vor?
- Die Haupt-Orchestrierungspipeline zu öffnen dauert eine Weile, und die gesuchte Aktivität darin zu finden auch.
- Um eine Quelle hinzuzufügen, kopieren Sie eine Kette aus Copy-Aktivitäten, Lookups und Stored-Procedure-Aufrufen und passen anschließend jeden Schritt einzeln an.
- Eine im Canvas gemachte Änderung war nicht die beabsichtigte Änderung, und das fiel in Test auf, oder später.
- Zwei Engineers haben dieselbe Pipeline in verschiedenen Branches bearbeitet, und der Merge wurde gelöst, indem eine genommen und die andere neu gemacht wurde.
Azure Data Factory ist das Standard-Integrationstool in jeder Azure-Landschaft, und für eine Handvoll Aktivitäten ist es genau richtig: Copy-Aktivität ziehen, auf eine Quelle richten, fertig. Die Probleme beginnen, wenn derselbe Ansatz für das ganze Warehouse verwendet wird und der Canvas Hunderte Aktivitäten hält, die nur die Leute lesen können, die sie gebaut haben.
Warum das Canvas nicht mehr skaliert
- Das Canvas ist die Dokumentation. Hinter einer Pipeline steht kein Modell, nur die Verknüpfungen. Was eine Pipeline tut, ist das, was ihre Bausteine und Pfeile tun, und das muss Baustein für Baustein gelesen werden.
- Jede Quelle ist eine Kopie der letzten. Für eine neue Tabelle duplizieren Sie eine Kette aus Copy-Aktivitäten, Lookups und Stored-Procedure-Aufrufen und bearbeiten anschließend jeden Schritt. Dass die Kopien mit der Zeit auseinanderlaufen, ist sicher.
- Änderungen werden von Hand in einer UI gemacht. Ein falsch gesetzter Abhängigkeitspfeil oder eine falsche Dataset-Referenz sieht korrekt aus, bis es läuft.
- Teamarbeit endet in komplexen JSON-Merges. Zwei Personen, die eine Pipeline in zwei Branches bearbeiten, treffen sich in einem Merge von generiertem Pipeline-JSON, und das reviewt niemand mit Zuversicht.
Das ist kein Designfehler von ADF. Ein Canvas ist das richtige Werkzeug, um ein paar Dinge zu orchestrieren, und das falsche, um ein Datenmodell auszudrücken.
Wo Orchestrierung und Logik hingehören
- In ein zentrales Modell statt auf ein Canvas. Business-Keys, Beziehungen und Attribute sollten einmal deklariert werden, und die Pipelines, die sie laden, aus dieser Deklaration abgeleitet werden.
- Generierter Code schützt vor Code-Drift. Wenn alle Staging- und Vault-Loads aus demselben Generator kommt, gibt es keine Version pro Quelle, die synchron zu halten wäre.
- Die Orchestrierung gehört zu den Loads. Datavault Builder führt Loads gebündelt als Jobs aus, in der richtigen Abhängigkeitsreihenfolge, mit Logging und Neustart. Für ADF bleiben Dateitransfers, Events und ein Trigger.
Was sich mit Datavault Builder ändert
Datavault Builder hält das Warehouse in einem visuellen Modell und generiert daraus die Staging, Historisierungs- und Auslieferungs-Loads, nativ auf Fabric, Synapse, Azure SQL oder SQL Server.
- Sie modellieren das Fachliche, den Rest baut die Plattform. Beschreiben Sie Entitäten, Schlüssel und Beziehungen einmal; Hubs, Links, Satelliten und sämtliche Loads werden daraus generiert. Es gibt keinen Canvas, der mit der Realität synchron zu halten wäre.
- Eine neue Quelle ist ein Mapping. Landing-Tabelle auf das Modell mappen und neu generieren. Keine Kette aus Aktivitäten, die zu kopieren und anzupassen wäre.
- Das Modell ist lesbar. Geschäftskonzepte, Schlüssel und Lineage sind an einem Ort sichtbar, für Fachanwender genauso wie für Engineers.
- Änderungen werden als Modelländerungen reviewt. Git und Gitflow-Unterstützung mit generierten Deployment- und Rollback-Skripten, statt eines Merge von Pipeline-JSON.
- ADF konzentriert sich auf seine Kernstärke. Dateitransfers und Events können weiterhin über ADF laufen, und es kann einen Datavault-Builder-Job auslösen. Die Orchestrierung der Loads selbst bleibt in der Plattform.
Was zu entscheiden ist
Öffnen Sie Ihre größte Orchestrierungspipeline und zählen Sie die Aktivitäten, die nur existieren, um pro Quelle zu kopieren, nachzuschlagen oder eine Stored Procedure aufzurufen. Diese Zahl ist der Teil des Canvas, den ein Modell generieren sollte.
Erleben Sie es live mit Ihren eigenen Datenquellen
Buchen Sie eine kostenlose Demo und bringen Sie den Connector mit, der Sie am meisten kostet, an Geld oder an Zeit.
In drei Schritten zu einer Pipeline, die Sie kontrollieren
-
Die Pipelines zählen, die nur bewegen und landen
Der Großteil einer großen Factory sind Copy, Lookup und Stored Procedure Ketten pro Quelle. Das ist Struktur, nicht Logik.
-
Stattdessen die Quellen modellieren
Business-Keys, Beziehungen und Attribute kommen ins Datavault Builder Modell. Die Ladepipelines werden daraus generiert.
-
ADF für das behalten, was es gut kann
Dateitransfers zwischen Azure Diensten und Event-Handling können in ADF bleiben. Höchstens löst es einen Datavault-Builder-Job aus; die Lade-Orchestrierung lebt in der Plattform.
Wie Datavault Builder die Reibungsverluste in der Ingestion beseitigt
-
Ingestion ist eingebaut
Batch-, Delta- und CDC-Ladevorgänge aus Datenbanken, Dateien, REST-APIs, NoSQL und Python-Quellen, mit Streams wie Kafka, die als Micro-Batches ankommen. Dieselbe Plattform, die das Warehouse generiert, keine zweite Rechnung.
-
Ihr Schema, nicht das des Anbieters
Quelltabellen werden auf ein Data-Vault-2.0-Modell gemappt, das Sie entworfen haben. Eine neue Spalte oder eine umbenannte Tabelle ändert ein Mapping, keine Kette von Skripten nach dem Load.
-
Nur Deltas bewegen sich
Hubs, Links und Satelliten laden, was sich geändert hat. Vollständige Ladevorgänge bleiben im Staging, statt jede Nacht weiter unten neu verarbeitet zu werden.
-
Historie wird von Haus aus behalten
Jede Änderung wird so festgehalten, wie sie eintrifft. Historien- und Stichtagsabfragen funktionieren also auch dort, wo die Quelle ihre eigenen Zeilen überschreibt.
-
Code, den Sie nie von Hand schreiben
Laden, Historisierung und Lineage werden in Echtzeit aus dem Modell generiert und laufen nativ auf Snowflake, Databricks, BigQuery, SQL Server, Fabric, Oracle oder PostgreSQL.
-
Eine Plattform, bis zu neun Tools weniger
Modellierung, ETL, CI/CD, Dokumentation und Lineage an einem Ort. Das ist es, was 14,7 Minuten von der Anforderung bis zur Produktion möglich macht.
Ausgezeichnet von BARC im Data Fabric Survey 26







Sprechen Sie mit unserem Experten
Zwanzig Minuten mit unserem Sales Director und eine ehrliche Antwort, ob das zu Ihrem Stack passt.

Matt Collett
Sales Director
Perfekt, wählen Sie einen passenden Termin:
Weitere Probleme in dieser Serie
-
Azure Data Factory Schwachstellen: Die versteckten Kosten von UI-Pipelines und Spark-Transformationen
Azure Data Factory ist eine solide Transportschicht innerhalb von Azure, eignet sich jedoch nicht für die Modellierung und Transformation eines Data Warehouse. Als All-in-One-Lösung führt es zu unübersichtlichen Pipeline-Diagrammen, fehleranfälligen ARM-Deployments und teuren Spark-Clustern für einfache SQL-Loads – und bindet die gesamte Logik unwiderruflich an Azure.
-
Kosten Ihre Azure Data Factory Mapping Data-Flows mehr als die Daten, die sie bewegen?
Mapping Data-Flows laufen auf einem verwalteten Spark-Cluster, der Minuten zum Starten braucht und pro vCore-Stunde abgerechnet wird. Für eine große nächtliche Transformation ist das vernünftig. Für ein paar Hunderttausend Zeilen ist es ein Cluster, der hochgefahren wird, um zu tun, was ein einziges SQL-Statement im Warehouse tun würde.
-
Wird jedes Azure Data Factory Release zu einem Kampf mit ARM-Templates?
Unter dem visuellen Editor ist eine Azure Data Factory JSON: Pipelines, Datasets, Linked Services und das ARM-Template, das sie deployt. Eine Änderung von Dev nach Prod zu bringen heißt Parameterdateien, globale Parameter und ein Template, das an einem einzigen Typkonflikt scheitert. Releases sollten aus einem Modell generiert werden, mit dem Rollback inklusive.
Fragen und Antworten
- Nein. ADF ist eine gute Transport- und Trigger-Schicht innerhalb von Azure. Das Argument ist, dass sein Einsatz als Modellierungs- und Transformationsschicht Hunderte von Hand verdrahtete Aktivitäten dorthin setzt, wo ein generiertes Modell sein sollte.
- Es entfernt die Kopie pro Quelle, und das ist ein echter Fortschritt. Was bleibt, ist ein Framework, das Sie gebaut haben und von Hand pflegen: die Control Tables, die generischen Pipelines, die Parameterverdrahtung und die Konventionen, die nur Ihr Team kennt. Und es deckt den Copy-Schritt ab; Schlüssel, Historisierung und Marts leben weiterhin woanders. Ein dedizierter Generator ist dieses Framework, gepflegt als Produkt, für das ganze Warehouse.
- Datavault Builder orchestriert seine eigenen Loads: Ein Job führt mehrere davon in der richtigen Reihenfolge aus, mit Logging und Neustart eingebaut. ADF kann einen solchen Job auslösen und weiterhin Dateien zwischen Azure Diensten bewegen. Es könnte einzelne Loads über die API aufrufen, aber es gibt keinen Grund, die Orchestrierung außerhalb der Plattform nachzubauen, die sie bereits hat. Sie beschreiben im Modell, worum es fachlich geht, und daraus werden die Strukturen und die Loads generiert. Auf dem Canvas bleiben Dateitransfers und ein Trigger.
- Microsofts Richtung ist Fabric, und Fabric Data Factory behält denselben Canvas: dieselben Aktivitäten, Schleifen und Ausdrücke, das Argument dieses Artikels ist also dasselbe, egal auf welcher Data Factory Sie sind. Was es nicht behält, ist der Rest: kein ARM Publish-Schritt, keine Mapping Data-Flows, stattdessen Dataflow Gen2 und Git-synchronisierte Items, abgerechnet in Capacity Units. Das generierte Warehouse läuft so oder so nativ auf Fabric.