Azure Data Factory のキャンバスが開発チームの手に負えなくなっていませんか?
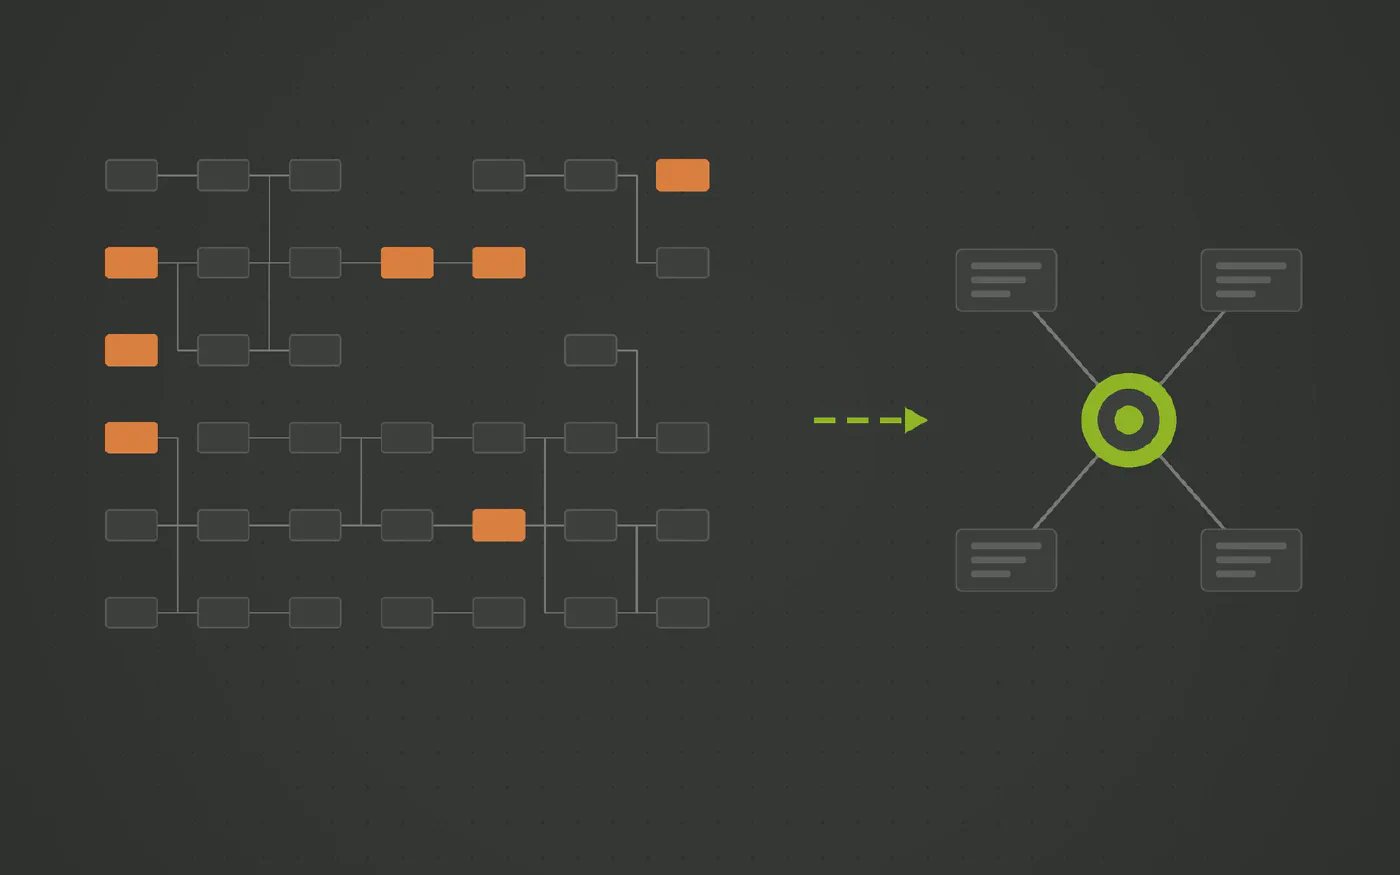
ドラッグ&ドロップのパイプラインは構築は迅速ですが、変更には多大な時間がかかります。数十のアクティビティを超えると、キャンバス自体がドキュメントと化し、配線作業がロジックを覆い隠します。解決策はキャンバスを整理することではなく、パイプラインを自動生成するモデルを導入することです。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション









このような課題はありませんか?
- メインのオーケストレーションパイプラインを開くのに時間がかかり、目的のアクティビティを探し出すのにも一苦労する。
- データソースを追加するたびに、Copy アクティビティ、Lookup、ストアドプロシージャの呼び出しチェーンをコピーし、各ステップを手作業で修正している。
- キャンバス上で行った変更が意図したものと異なっており、テスト環境やそれ以降のフェーズで初めて不具合が発覚する。
- 2 人のエンジニアが別々のブランチで同じパイプラインを編集した結果、マージ競合を解決できず、一方を採用して他方を手作業で作り直すことになった。
Azure Data Factory は、Azure 環境における標準的なデータ統合ツールです。少数のアクティビティを組むだけであれば、Copy アクティビティをドラッグし、ソースを指定するだけで完了するため、まさに最適な選択肢と言えます。しかし、データウェアハウス全体に同じアプローチを適用し、配線した本人しか解読できない何百ものアクティビティがキャンバスを埋め尽くすようになったとき、深刻な問題が始まります。
キャンバスがスケールしなくなる理由
- キャンバス自体がドキュメント化してしまう: パイプラインの背後にはデータモデルが存在せず、あるのは視覚的な配線だけです。パイプラインが何を行っているかを理解するには、ボックスと矢印を 1 つひとつ順番に読み解くしかありません。
- すべてのソースが過去のパイプラインのコピー&ペーストになる: 新しいテーブルを 1 つ追加するたびに、Copy アクティビティ、Lookup、ストアドプロシージャ呼び出しのチェーンを複製し、各ステップを手作業で書き換える必要があります。その結果、コピー元とコピー先の間で設定の乖離が確実に発生します。
- UI 上で手作業による変更が行われる: 依存関係の矢印の引き間違いやデータセット参照の誤りは、画面上では正しく見えても、実際に実行してエラーが出るまで気づけません。
- チーム開発が複雑な JSON のマージ作業に化ける: 2 人のエンジニアが 2 つのブランチで同じパイプラインを編集すると、自動生成された複雑なパイプライン JSON のマージを迫られます。しかし、その差分を自信を持ってコードレビューできる人はいません。
これらは ADF 自体の欠陥ではありません。キャンバスは少数の処理をオーケストレーションするには優れたツールですが、データモデルを表現するためのツールとしては根本的に不向きなのです。
ワイヤリングが本来属するべき場所
- キャンバス上ではなく、モデルの内部: ビジネスキー、リレーションシップ、属性は 1 度だけ宣言されるべきであり、それらをロードするパイプラインはその定義から自動的に導出されるべきです。
- 自動生成によってコピーの乖離を防ぐ: すべてのステージングおよび Vault のロード処理が同一のジェネレーターから生成されれば、ソースごとに個別のバージョンを手動で同期し続ける必要はなくなります。
- ロードの依存関係制御はロード処理自身に持たせる: Datavault Builder は、依存関係の順序に従い、ログ記録と再試行機能を備えたジョブとしてロード群を実行します。ADF に残る役割は、ファイル移動、イベント処理、そしてトリガーの発行だけです。
Datavault Builder による変革
Datavault Builder は、ビジュアルなデータモデルとしてデータウェアハウスを管理し、ステージング、履歴保持、ビジネス層への配信ロードをモデルから直接自動生成します。生成されたコードは、Fabric、Synapse、Azure SQL、SQL Server 上でネイティブに実行されます。
- ビジネスをモデル化すれば、残りはプラットフォームが自動構築: エンティティ、キー、リレーションシップを 1 度定義するだけで、Hub、Link、Satellite、そしてすべてのロード処理がそのモデルから自動生成されます。現実のコードと同期を取り続けなければならないキャンバスは存在しません。
- 新しいソースの追加は単なるマッピング作業: ランディングテーブルをモデルにマッピングして再生成するだけです。アクティビティのチェーンをコピーして修正する作業は不要になります。
- モデルを誰もが直感的に理解可能: ビジネス概念、キー、データリネージが 1 か所に可視化され、エンジニアだけでなくビジネスユーザーも容易に把握できます。
- 変更はモデルの差分としてレビュー: パイプライン JSON のマージに頭を悩ませる代わりに、Git および Gitflow をネイティブサポートし、自動生成されたデプロイおよびロールバックスクリプトとして安全にレビューできます。
- ADF は身軽なタスクに専念: ファイル移動やイベント処理は引き続き ADF で実行し、Datavault Builder のジョブをキックするトリガーとして活用できます。ロード処理自体の複雑なオーケストレーションはプラットフォーム内部で完結します。
今すぐ判断すべきこと
運用中の最も巨大なパイプラインを開き、ソースごとのコピー、参照、ストアドプロシージャの呼び出しのためだけに存在しているアクティビティの数を数えてみてください。その数値こそが、手作業のキャンバスから解放し、データモデルによって自動生成すべき領域の大きさを示しています。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
データパイプラインを自社で完全に掌握する 3 つのステップ
-
データの移動と配置だけを行うパイプラインを把握する
大規模な Data Factory の大部分は、ソースごとのコピー、参照、ストアドプロシージャの呼び出しチェーンに過ぎません。これは単なる構造であり、ビジネスロジックではありません。
-
キャンバスではなくソースデータをモデル化する
ビジネスキー、リレーションシップ、属性を Datavault Builder のモデルに定義します。ロード用パイプラインはすべてそのモデルから自動生成されます。
-
ADF の本来の強みである領域に専念させる
Azure サービス間のファイル移動やイベントハンドリングは ADF に任せます。ADF はせいぜい Datavault Builder のジョブをトリガーするだけで十分であり、データロードの依存関係制御はプラットフォーム側に委ねられます。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得







専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。

Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
Azure Data Factory の課題:UI パイプラインと Spark 変換の隠れたコスト
Azure Data Factory は Azure 内部のデータ転送層としては優れていますが、データウェアハウスを保持する場所としては不向きです。モデリングや変換基盤として使ってしまうと、誰も解読できないキャンバス、ARM テンプレートのデプロイ失敗、1 行の SQL で済む処理のための Spark クラスターなど、多くの摩擦が生じます。そして何より、それらのパイプラインはすべて Azure 専用に縛られています。
-
Azure Data Factory の Mapping Data Flow のコストがデータ価値を上回っていませんか?
Mapping Data Flow はマネージド Spark クラスター上で実行され、起動に数分を要し、vCore 時間単位で課金されます。夜間の大規模なデータ変換であれば妥当ですが、数十万行程度の処理のためにクラスターを起動するのは、ウェアハウス内の単一の SQL 文で済む作業に対して過剰なコストを払っていることになります。
-
Azure Data Factory のリリースが ARM テンプレートの修正作業に追われていませんか?
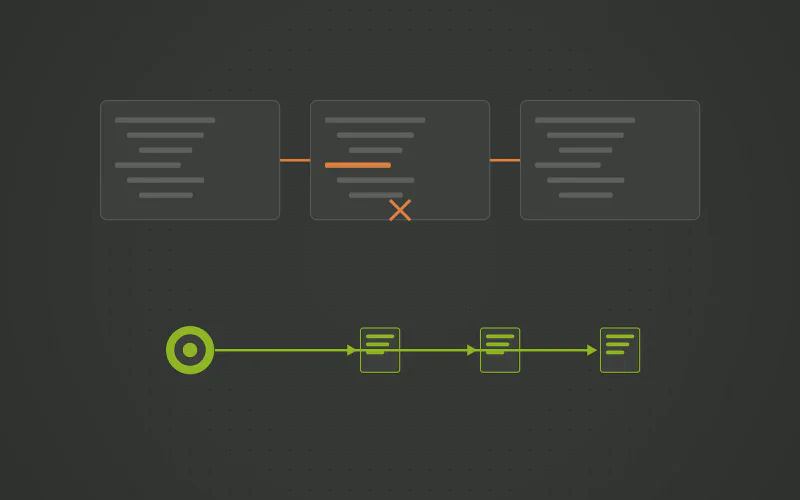
ビジュアルエディタの裏側で、Azure Data Factory の実体は JSON です。パイプライン、データセット、リンクサービス、そしてそれらをデプロイする ARM テンプレートで構成されています。開発環境から本番環境へリリースする際、パラメータファイルやグローバルパラメータの調整に追われ、わずか 1 つのデータ型の不一致でデプロイが中断します。リリースはロールバック機能も含めてモデルから自動生成されるべきです。
よくあるご質問
- いいえ、そうではありません。ADF は Azure 内部におけるトランスポート層およびトリガー層として非常に優れています。問題は、モデリングやデータ変換のレイヤーとして ADF を使ってしまうことで、本来モデルから自動生成されるべき場所に、何百もの手作業で配線されたアクティビティが氾濫してしまう点です。
- ソースごとの個別コピー処理を排除できている点は大きな進歩です。しかし、手作業で構築・保守し続けなければならないフレームワーク(コントロールテーブル、汎用パイプライン、パラメータの受け渡し構造、自社チームしか知らないローカルルール)が依然として残ります。しかもそれはコピー処理をカバーしているに過ぎず、ビジネスキー管理、履歴保持、データマート生成は依然として別の場所に依存しています。真の自動生成とは、データウェアハウス全体をカバーし、商用製品として継続的に保守・洗練されたフレームワークを指します。
- Datavault Builder は自身でデータロードをオーケストレーションします。一連のロード処理を依存関係に基づいた適切な順序で実行し、ログ記録や自動再試行機能も標準装備しています。ADF はそのジョブをトリガーしたり、Azure サービス間のファイル移動を担ったりできます。API を介して個別ロードを呼び出すことも可能ですが、すでに完成されたオーケストレーション機構が備わっているため、外部でわざわざ再構築する必要はありません。モデル上でビジネス要件を定義すれば、テーブル構造とロードパイプラインが自動生成されます。キャンバス上に残るのは、ファイルの受け渡しとトリガーの実行だけです。
- マイクロソフトが示す今後の方向性は Fabric であり、Fabric Data Factory も同じキャンバスを採用しています。アクティビティ、ループ、論理式も共通であるため、どちらの Data Factory を使っていても本記事の課題は全く同じです。一方、ARM 発行ステップや Mapping Data Flow は廃止され、Git 同期アイテムと Dataflow Gen2 に置き換わり、Capacity Unit(CU)単位で課金されます。いずれの場合も、自動生成されたデータウェアハウスは Fabric 上でネイティブに動作します。