¿Sus expresiones de Set Analysis en Qlik son demasiado largas y lentas?
Set Analysis es preciso para comparaciones genuinas. La mayoría de las expresiones largas de su aplicación están ahí porque el modelo nunca entregó historial, indicadores ni una única granularidad, así que el gráfico los reconstruye con cada selección.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores
¿Le suena familiar?
- Una sola expresión ocupa varias líneas de modificadores de conjunto anidados y llamadas a Aggr.
- Los gráficos muestran el indicador de cálculo después de cada selección.
- Usa Set Analysis para averiguar cuál era un valor en un momento determinado.
- Solo la persona que escribió la medida maestra se atreve a cambiarla.
Set Analysis es la herramienta correcta para una comparación genuina, como este año frente al anterior. También es el sitio donde acaba la solución cuando al modelo le falta algo, y ese tipo es el que ralentiza la aplicación.
Qué están sustituyendo las expresiones largas
- Historial. Modificadores de fecha y
Aggrreconstruyendo el estado que tenía un registro el pasado marzo. - Indicadores. Condiciones
If()dentro de la expresión que deciden qué cuenta como activo o válido, en cada cálculo. - Granularidad.
AggryOnlydeshaciendo la duplicación de una tabla que contiene dos granularidades a la vez. - Relaciones que faltan. Modificadores anidados como
{<Year={2024}>}combinados conP()haciendo lo que haría una dimensión bien construida.
Cada una se evalúa por gráfico, por selección y por usuario. Esa es la espera.
Por qué le toca a usted
- Cada expresión fue la ruta más rápida hacia una cifra correcta esa semana.
- La lógica vive dentro del
.qvf, así que nadie fuera de la aplicación puede revisarla ni reutilizarla. - Puede simplificar la expresión. No puede añadir el historial que el modelo nunca guardó.
El trabajo está en el lugar equivocado
- Historial, indicadores y granularidad son trabajo del data warehouse. En Set Analysis se recalculan con cada selección.
- Debe hacerse en un único lugar central: un data warehouse o un data hub, construido una vez y leído por todas las aplicaciones.
- Si eso le parece caro, probablemente la estimación parte de pipelines construidos a mano. Una plataforma de automatización especializada los genera a partir de un modelo, lo que cambia tanto el coste como el tiempo necesario.
Qué cambia cuando el modelo llega terminado
Datavault Builder genera el vault y el star schema de forma nativa en la base de datos que ya utiliza, como SQL Server, Azure SQL, Oracle, Snowflake y Databricks.
- El historial se guarda como satélites, y las tablas point in time responden “a fecha de marzo” con un join.
- Los indicadores son columnas, calculadas una sola vez en el warehouse en lugar de dentro de cada expresión.
- Una sola granularidad por tabla de hechos, lo que elimina directamente la mayor parte del trabajo de
Aggr. - Las dimensiones conformadas dan a los modificadores de conjunto campos reales sobre los que seleccionar.
- Lo que queda son comparaciones genuinas, lo bastante cortas para que un colega las lea.
Qué pedir
No “el dashboard va lento”, sino:
“Nuestro Set Analysis reconstruye el estado en un momento determinado y los indicadores de estado con cada selección. ¿Puede el warehouse darnos una tabla point in time y los indicadores como columnas, para que las expresiones sean sumas simples?”
Así distingue el Set Analysis que realmente necesita del Set Analysis que usa como parche.
Véalo funcionando con sus propios datos
Reserve una demo gratuita y traiga el informe que más problemas le da.
Tres pasos hacia cifras que cuadran
-
Extraer la lógica existente
Reúna los cálculos, joins y filtros que hoy viven en sus informes.
-
Centralizarla en un solo lugar
La lógica pasa una sola vez al modelo del warehouse, y todos los informes leen la misma definición.
-
Cifras que cuadran
Todos los informes muestran la misma cifra, y “de dónde sale esta cifra” tiene una respuesta visible.
Cómo Datavault Builder entrega a su informe un modelo terminado
-
El modelo llega terminado
Datavault Builder genera el vault y el star schema para que se ejecuten de forma nativa en la base de datos que ya tiene: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks o BigQuery.
-
El trabajo sale del informe
Sin merge, sin parsing, sin fuzzy match. Ese trabajo desaparece del informe.
-
Las fuentes llegan integradas
Los clientes del ERP, el CRM y la tienda online se consolidan en un único conjunto de dimensiones conformadas. El join se hace una vez en el warehouse, no de nuevo en cada informe.
-
Historial que puede consultar
Cada cambio se conserva tal como llega, así que puede analizar tanto cómo era como cómo es, incluso cuando el sistema de origen sobrescribe sus propios registros.
-
Cada cifra tiene lineage
La lógica gana lineage, así que “de dónde sale esta cifra” tiene una respuesta visible.
-
Cambios gestionados en el origen
Las dimensiones de cambio lento se gestionan en el origen como satélites del vault, no por aproximación.
Reconocido por BARC en The Data Fabric Survey 26
Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su situación.
Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
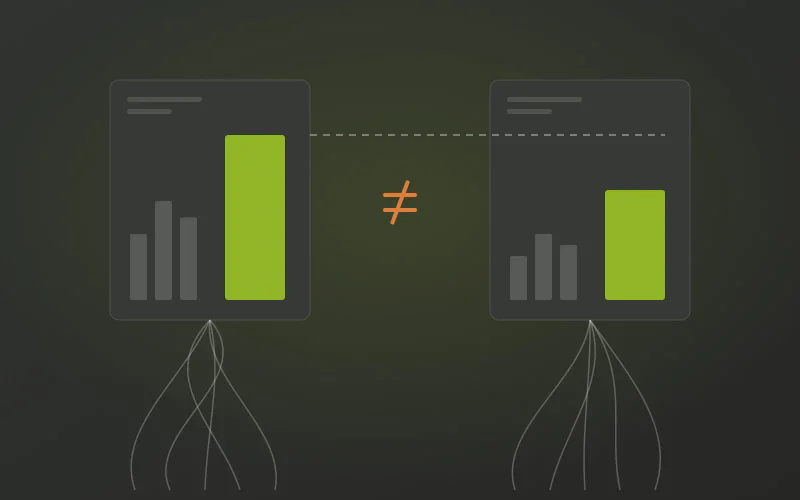
¿Sus aplicaciones de Qlik y sus informes de Power BI muestran cifras distintas?
Ni Qlik ni Power BI se equivocan. Cada uno tiene su propia lógica de carga, sus propias definiciones y su propio lineage, así que la misma métrica se calcula dos veces y nadie puede conciliarlas. Las reglas deben estar en un único modelo gobernado del warehouse que lean ambas herramientas.
-
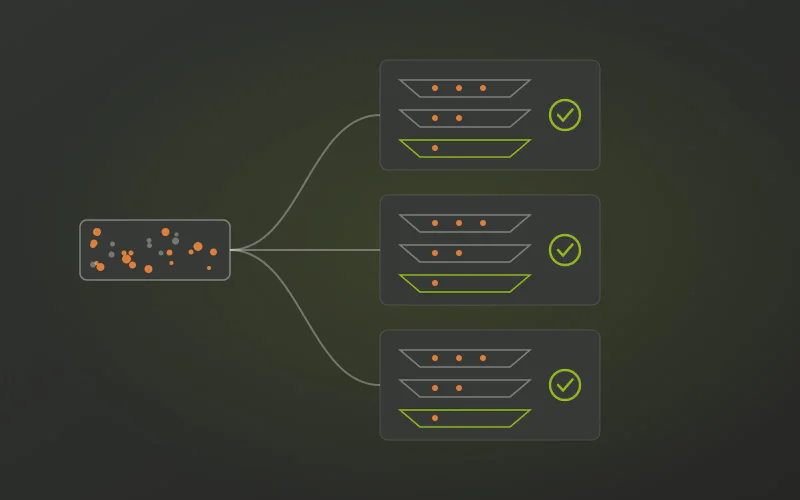
¿Limpia los mismos datos una y otra vez en cada script de carga de Qlik?
Los mismos mapping loads, correcciones de cadenas y eliminación de duplicados se escriben de nuevo en cada aplicación y en cada capa de QVD, y las copias acaban divergiendo. La limpieza se repite en cada script porque ninguna capa integrada del warehouse la hace una sola vez.
-
¿Sus aplicaciones de Qlik crean claves sintéticas una y otra vez?
Las claves sintéticas y las referencias circulares son Qlik asociando exactamente lo que recibe. Aparecen porque los datos llegan sin dimensiones conformadas ni claves reales, así que cada aplicación tiene que inventarlas.