¿Limpia los mismos datos una y otra vez en cada script de carga de Qlik?
Los mismos mapping loads, correcciones de cadenas y eliminación de duplicados se escriben de nuevo en cada aplicación y en cada capa de QVD, y las copias acaban divergiendo. La limpieza se repite en cada script porque ninguna capa integrada del warehouse la hace una sola vez.
La plataforma de automatización de data warehouse en la que confían equipos de datos de todos los sectores
¿Le suena familiar?
- La misma lógica de ApplyMap y Trim está en varios scripts de carga, y las copias ya no coinciden.
- Un código de país nuevo en el origen obliga a editar la tabla de mapeo en cada aplicación que la usa.
- Dos aplicaciones muestran recuentos de clientes distintos porque eliminan los duplicados del mismo origen de forma distinta.
- Nadie sabe con seguridad qué script contiene la versión actual de una regla de limpieza.
Una aplicación que limpia datos en bruto es un apaño. Diez aplicaciones que limpian los mismos datos en bruto, cada una de forma algo distinta, son un segundo warehouse que nadie diseñó.
Dónde se vuelve a escribir la misma limpieza
- Cada aplicación copia el mapeo. El mismo
MAPPING LOADyApplyMappara códigos de país, producto y cliente, pegado en cada script que necesita el campo. - Cada copia diverge. Un script aplica trim y pasa a mayúsculas, otro no, un tercero añadió un código nuevo el mes pasado. El mismo campo, valores distintos.
- Cada capa de QVD lo repite. Las aplicaciones de extracción, transformación y generación de QVD limpian los datos, y la siguiente aplicación los vuelve a limpiar por si acaso.
- Cada cambio es una búsqueda. Un código nuevo del origen hay que encontrarlo y corregirlo en cada script, y el que se pasó por alto falla sin avisar.
Un archivo $(Include) mantiene el texto idéntico. No impide que cada aplicación decida si lo usa,
cuándo y en qué orden.
Por qué le toca a usted
- Cada aplicación se construyó cuando hacía falta, y copiar las correcciones del último script era la forma más rápida de entregarla.
- Nadie es responsable de la regla, así que nadie se da cuenta cuando dos scripts empiezan a no coincidir.
- Puede alinear los scripts que mantiene. No puede impedir que el origen envíe datos en bruto a todos ellos.
El trabajo está en el lugar equivocado
- Limpiar los datos de origen es trabajo del data warehouse. En Qlik se vuelve a escribir en cada script de carga que toca el campo.
- Debe hacerse en un único lugar central: un data warehouse o un data hub, construido una vez y leído por todas las aplicaciones.
- Si eso le parece caro, probablemente la estimación parte de pipelines construidos a mano. Una plataforma de automatización especializada los genera a partir de un modelo, lo que cambia tanto el coste como el tiempo necesario.
Qué cambia cuando el modelo llega terminado
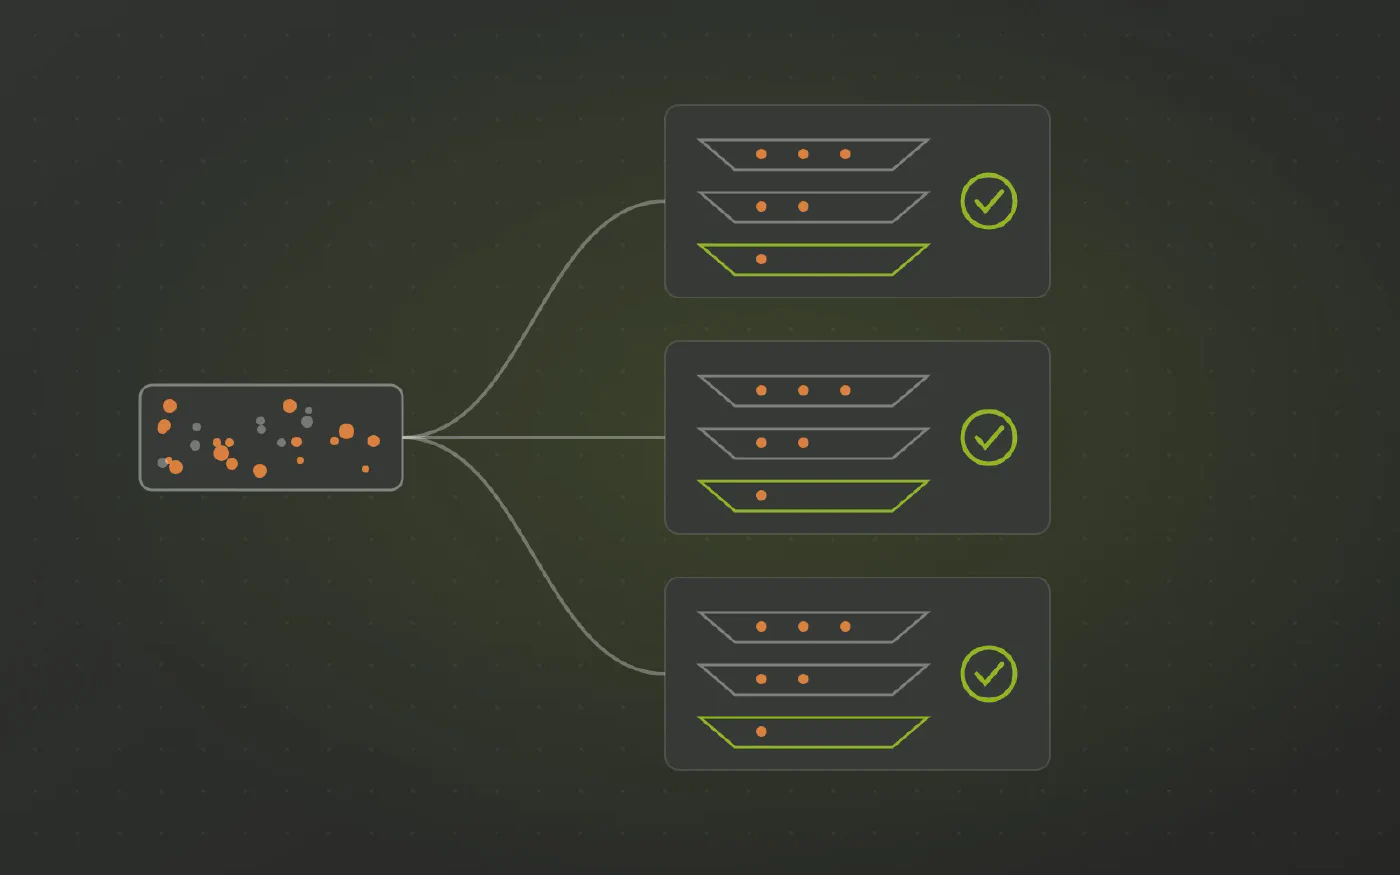
Datavault Builder genera el vault integrado e historizado y la capa dimensional encima, de forma nativa en la base de datos que ya utiliza, desde SQL Server y Azure SQL hasta Snowflake o BigQuery.
- Cada regla de limpieza se define una sola vez, así que un mapeo de códigos cambia en un solo lugar, no en cada script.
- Los duplicados se resuelven en la integración, a partir de claves de negocio en lugar de filtrarse en cada aplicación.
- El historial se guarda como satélites, así que ningún QVD tiene que conservar la versión de ayer.
- El script de carga se convierte en un simple
LOADdesde tablas limpias, lo bastante corto para leerlo. - El lineage muestra cada transformación, así que una regla modificada se puede rastrear antes de desplegarla.
Qué pedir
No “el script de transformación es un caos”, sino:
“Limpiamos y mapeamos los mismos campos de origen en varias aplicaciones generadoras de QVD, y ya no coinciden. ¿Puede esa limpieza vivir en una capa integrada del warehouse, para que nuestras aplicaciones carguen dimensiones terminadas en lugar de extracts en bruto?”
Si construir esa capa suena a un año de trabajo de pipelines, la estimación supone que se escribe a mano. Esa es precisamente la parte que genera Datavault Builder.
Véalo funcionando con sus propios datos
Reserve una demo gratuita y traiga el informe que más problemas le da.
Tres pasos hacia cifras que cuadran
-
Extraer la lógica existente
Reúna los cálculos, joins y filtros que hoy viven en sus informes.
-
Centralizarla en un solo lugar
La lógica pasa una sola vez al modelo del warehouse, y todos los informes leen la misma definición.
-
Cifras que cuadran
Todos los informes muestran la misma cifra, y “de dónde sale esta cifra” tiene una respuesta visible.
Cómo Datavault Builder entrega a su informe un modelo terminado
-
El modelo llega terminado
Datavault Builder genera el vault y el star schema para que se ejecuten de forma nativa en la base de datos que ya tiene: SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks o BigQuery.
-
El trabajo sale del informe
Sin merge, sin parsing, sin fuzzy match. Ese trabajo desaparece del informe.
-
Las fuentes llegan integradas
Los clientes del ERP, el CRM y la tienda online se consolidan en un único conjunto de dimensiones conformadas. El join se hace una vez en el warehouse, no de nuevo en cada informe.
-
Historial que puede consultar
Cada cambio se conserva tal como llega, así que puede analizar tanto cómo era como cómo es, incluso cuando el sistema de origen sobrescribe sus propios registros.
-
Cada cifra tiene lineage
La lógica gana lineage, así que “de dónde sale esta cifra” tiene una respuesta visible.
-
Cambios gestionados en el origen
Las dimensiones de cambio lento se gestionan en el origen como satélites del vault, no por aproximación.
Reconocido por BARC en The Data Fabric Survey 26
Hable con nuestro experto
Veinte minutos con nuestro Sales Director y una respuesta honesta sobre si esto encaja con su situación.
Matt Collett
Sales Director
Perfecto, elija un horario que le venga bien:
Otros problemas que cubre esta serie
-
¿Sus aplicaciones de Qlik y sus informes de Power BI muestran cifras distintas?
Ni Qlik ni Power BI se equivocan. Cada uno tiene su propia lógica de carga, sus propias definiciones y su propio lineage, así que la misma métrica se calcula dos veces y nadie puede conciliarlas. Las reglas deben estar en un único modelo gobernado del warehouse que lean ambas herramientas.
-
¿Sus expresiones de Set Analysis en Qlik son demasiado largas y lentas?
Set Analysis es preciso para comparaciones genuinas. La mayoría de las expresiones largas de su aplicación están ahí porque el modelo nunca entregó historial, indicadores ni una única granularidad, así que el gráfico los reconstruye con cada selección.
-
¿Sus aplicaciones de Qlik crean claves sintéticas una y otra vez?
Las claves sintéticas y las referencias circulares son Qlik asociando exactamente lo que recibe. Aparecen porque los datos llegan sin dimensiones conformadas ni claves reales, así que cada aplicación tiene que inventarlas.