Nettoyez-vous les mêmes données dans chaque script de chargement Qlik ?
Les mêmes MAPPING LOAD, corrections de chaînes et dédoublonnages sont réécrits dans chaque application et chaque couche QVD, et les copies divergent. Le nettoyage est répété script par script parce qu'aucune couche de warehouse intégrée ne le fait une seule fois.
La plateforme d'automatisation de data warehouse à laquelle font confiance les équipes data de tous les secteurs
Cela vous semble familier ?
- La même logique ApplyMap et Trim se trouve dans plusieurs scripts de chargement, et les copies ne concordent plus.
- Un nouveau code pays dans la source oblige à modifier la table de mapping dans chaque application qui l'utilise.
- Deux applications affichent des nombres de clients différents, parce qu'elles dédoublonnent la même source différemment.
- Personne ne sait avec certitude quel script contient la version actuelle d'une règle de nettoyage.
Une application qui nettoie des données brutes, c’est un contournement. Dix applications qui nettoient les mêmes données brutes, chacune un peu différemment, c’est un second warehouse que personne n’a conçu.
Où le même nettoyage est réécrit
- Chaque application copie le mapping. Le même
MAPPING LOADet le mêmeApplyMappour les codes pays, produit et client, collés dans chaque script qui a besoin du champ. - Chaque copie diverge. Un script supprime les espaces et passe en majuscules, un autre non, un troisième a ajouté un nouveau code le mois dernier. Même champ, valeurs différentes.
- Chaque couche QVD le répète. Les applications d’extraction, de transformation et de génération de QVD nettoient les données, et l’application suivante les nettoie encore une fois, par précaution.
- Chaque modification est une recherche. Un nouveau code source doit être trouvé et corrigé dans chaque script, et celui qu’on a oublié échoue sans bruit.
Un fichier $(Include) garde le texte identique. Il n’empêche pas chaque application de décider si,
quand et dans quel ordre l’utiliser.
Pourquoi cela retombe sur vous
- Chaque application a été construite au moment où on en avait besoin, et copier les corrections du dernier script était le moyen le plus rapide de la livrer.
- Personne n’est responsable de la règle, donc personne ne remarque quand deux scripts commencent à diverger.
- Vous pouvez aligner les scripts que vous maintenez. Vous ne pouvez pas empêcher la source d’envoyer des données brutes à chacun d’eux.
Le travail se fait au mauvais endroit
- Nettoyer les données source est un travail de warehouse. Dans Qlik, il est réécrit dans chaque script de chargement qui touche le champ.
- Ce travail a sa place dans un endroit central : un data warehouse ou un data hub, construit une fois et lu par chaque application.
- Si cela semble coûteux, l’estimation suppose probablement des pipelines construits à la main. Une plateforme d’automatisation spécialisée les génère à partir d’un modèle, ce qui change à la fois le coût et le délai.
Ce qui change quand le modèle arrive prêt à l’emploi
Datavault Builder génère le vault intégré et historisé, ainsi que la couche dimensionnelle au-dessus, nativement dans la base de données que vous exploitez déjà, de SQL Server et Azure SQL à Snowflake ou BigQuery.
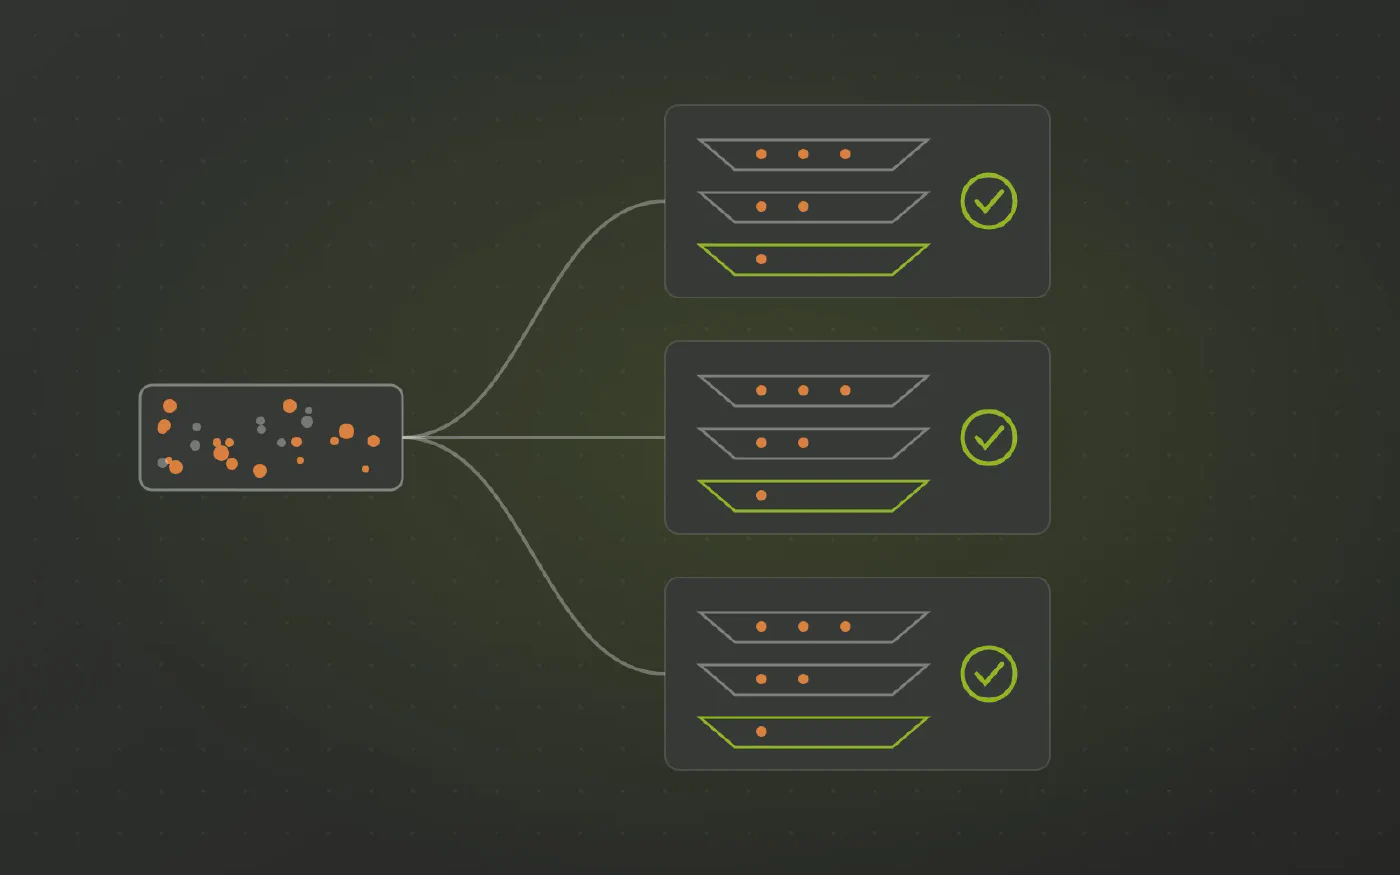
- Chaque règle de nettoyage est définie une seule fois, donc un mapping de codes change à un seul endroit, pas dans chaque script.
- Les doublons sont résolus à l’intégration, sur la base des clés métier plutôt que filtrés application par application.
- L’historique est conservé sous forme de satellites, donc aucun QVD n’a à préserver la version de la veille.
- Le script de chargement devient un simple
LOADdepuis des tables nettoyées, assez court pour être lu. - Le lineage montre chaque transformation, donc une règle modifiée peut être tracée avant son déploiement.
Ce qu’il faut demander
Pas « le script de transformation est un fouillis », mais :
« Nous nettoyons et mappons les mêmes champs source dans plusieurs applications de génération de QVD, et elles ne concordent plus. Ce nettoyage peut-il vivre dans une couche de warehouse intégrée, pour que nos applications chargent des dimensions finies au lieu d’extraits bruts ? »
Si construire cette couche ressemble à une année de travail sur les pipelines, l’estimation suppose qu’ils sont écrits à la main. C’est précisément la partie que Datavault Builder génère.
Voyez-le fonctionner sur vos propres données
Réservez une démo gratuite et apportez le rapport qui vous pose le plus de problèmes.
Trois étapes vers des chiffres qui concordent
-
Extraire la logique existante
Rassemblez les calculs, jointures et filtres qui vivent aujourd’hui dans vos rapports.
-
La centraliser en un seul endroit
La logique passe une seule fois dans le modèle du warehouse, et chaque rapport lit la même définition.
-
Des chiffres qui concordent
Chaque rapport affiche le même chiffre, et « d’où vient ce chiffre » a une réponse visible.
Comment Datavault Builder fournit à votre rapport un modèle prêt à l'emploi
-
Le modèle arrive prêt à l'emploi
Datavault Builder génère le vault et le schéma en étoile pour qu’ils s’exécutent nativement dans la base de données dont vous disposez déjà : SQL Server, Azure SQL, Synapse, Fabric, Snowflake, Databricks ou BigQuery.
-
Le travail quitte le rapport
Pas de fusion, pas de parsing, pas de correspondance approximative. Ce travail a disparu du rapport.
-
Les sources arrivent intégrées
Les clients de l’ERP, du CRM et de la boutique en ligne sont rapprochés en un seul ensemble de dimensions conformes. La jointure a lieu une fois dans le warehouse, et non à nouveau dans chaque rapport.
-
Un historique interrogeable
Chaque modification est conservée à son arrivée, vous pouvez donc produire des rapports sur l’état passé comme sur l’état actuel, même lorsque le système source écrase ses propres enregistrements.
-
Chaque chiffre a son lineage
La logique gagne un lineage, donc « d’où vient ce chiffre » a une réponse visible.
-
Évolutions gérées en amont
Les dimensions à évolution lente sont gérées en amont sous forme de satellites du vault, pas approximées.
Reconnu par BARC dans The Data Fabric Survey 26
Rencontrez notre expert
Vingt minutes avec notre Sales Director, et une réponse honnête sur l’adéquation avec votre situation.
Matt Collett
Sales Director
Parfait, choisissez un créneau qui vous convient :
Autres problèmes traités dans cette série
-
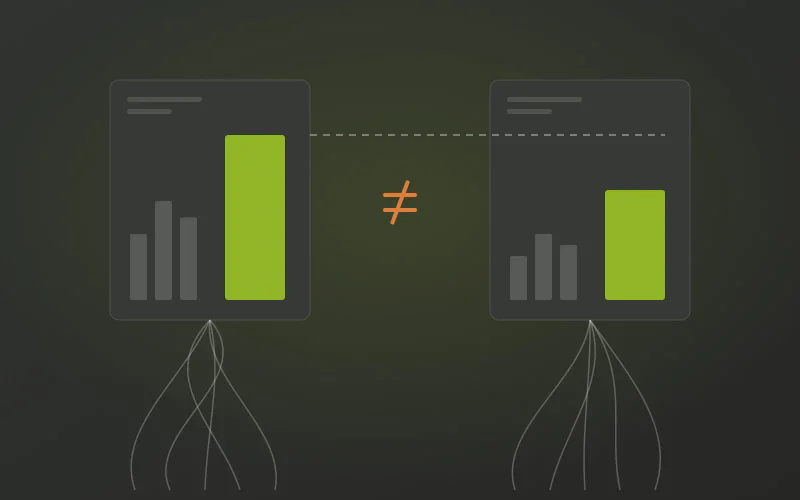
Vos applications Qlik et vos rapports Power BI affichent-ils des chiffres différents ?
Ni Qlik ni Power BI n’a tort. Chacun a sa propre logique de chargement, ses propres définitions et son propre lineage, donc la même métrique est calculée deux fois et personne ne peut rapprocher les résultats. Les règles ont leur place dans un modèle de warehouse gouverné que les deux outils lisent.
-
Vos expressions Set Analysis Qlik sont-elles trop longues et trop lentes ?
Le Set Analysis est précis pour de vraies comparaisons. La plupart des longues expressions de votre application existent parce que le modèle n’a jamais fourni l’historique, les flags ou une granularité unique, et le graphique les reconstruit donc à chaque sélection.
-
Vos applications Qlik créent-elles sans cesse des clés synthétiques ?
Les clés synthétiques et les références circulaires, c’est Qlik qui associe exactement ce qu’on lui a fourni. Elles apparaissent parce que les données arrivent sans dimensions conformes ni vraies clés, et chaque application doit donc les inventer.