SSIS はクラウドデータウェアハウスの境界で力尽きていませんか?
SSIS はオンプレミスの SQL Server インスタンス間でデータを移動するために設計されました。ウェアハウスを Fabric、Snowflake、Databricks、BigQuery へ移行する際、パッケージをクラウド上の Azure-SSIS IR に載せ替えるか、サードパーティ製コネクタを購入するか、全面再開発するかの選択を迫られます。新しいプラットフォーム向けにコードをネイティブ自動生成するモデルこそが、レガシーパッケージを持ち込まずに済む第 4 の選択肢です。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション









このような課題はありませんか?
- ウェアハウスを Fabric や Snowflake へ移行する計画において、既存の SSIS パッケージをそのままクラウド VM 上で動かし続ける予定になっている。
- 非マイクロソフト系のデータソースやターゲットへデータをロードするために、個別にライセンスやアップグレード管理が必要なサードパーティ製コネクタを購入している。
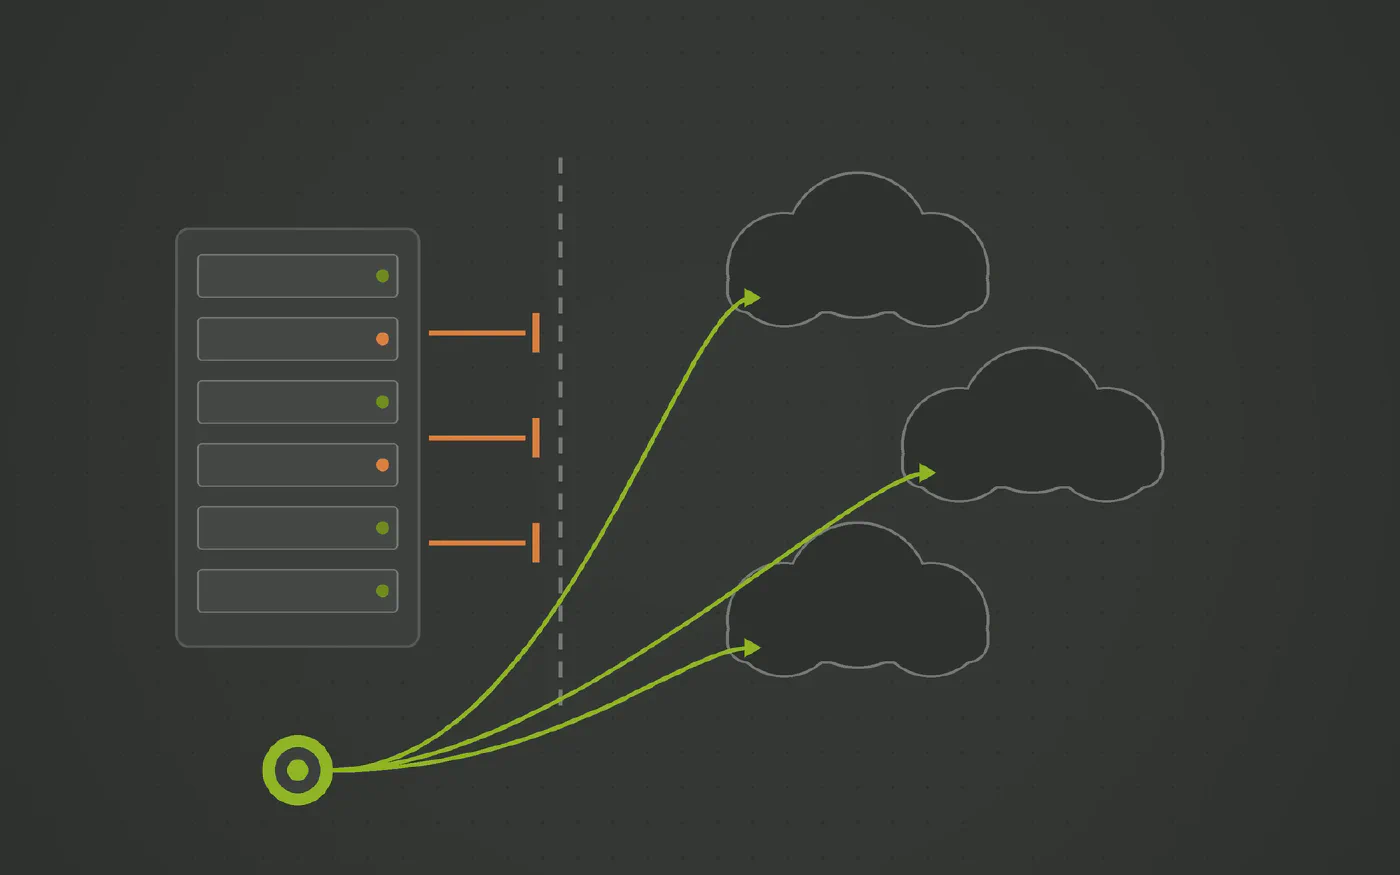
- 大規模なデータロードが 1 台のサーバー上の SSIS データフローバッファを通過するため、そのサーバー自体のスペックがシステム全体のボトルネックになっている。
- ソースでもウェアハウスでもない、単にパッケージを実行するだけの中間 ETL サーバーのために、別途高額な SQL Server ライセンス費用を支払っている。
SSIS は、データソースとデータウェアハウスの双方が SQL Server であり、往々にして同一データセンター内に存在していた時代の産物です。その前提においては非常に優れたツールでした。しかし、ウェアハウスが Microsoft Fabric、Snowflake、Databricks、Google BigQuery などのモダンなクラウド環境へと移行した瞬間、既存パッケージの追従が極めて困難になります。
SSIS がプラットフォームの境界で力尽きる理由
- 両端が SQL Server であることを前提とした設計: 非マイクロソフト系のシステムを対象にするには、独自ライセンスとバージョン管理を伴うサードパーティ製コネクタの追加導入が避けられません。
- データ変換が中間 ETL サーバー上で実行される: データはネットワークを経由して SSIS サーバーに運ばれ、そこのデータフローバッファメモリを通過し、再びネットワークを越えてウェアハウスへ書き込まれます。サーバーのメモリと CPU コアがボトルネックとなり、2 重のデータ転送コストが毎回発生します。
- ETL サーバー専用のライセンス費用: SSIS は SQL Server に付随するため、パッケージを実行するだけの中間サーバーに対しても SQL Server ライセンスが必要です。
- クラウドへの移行が「単なるリフト」に終わる: Azure-SSIS Integration Runtime は、過去のパッケージをそのままの形で Azure 上で稼働させます。オンプレミスで抱えていたすべての技術的負債が、そのままクラウド上へと引き継がれてしまいます。
これは SSIS 自体の不具合ではありません。単一プラットフォーム向けに設計され、その使命を全うしたツールだからこその限界です。
ロード処理が本来属するべき場所
- ターゲットデータベースエンジン内部: Fabric、Snowflake、Databricks、BigQuery は強力なセットベースエンジンです。自動生成された差分ロードは、中間サーバーを介さずに、ウェアハウス自身のコンピュート上で直接高速に実行されるべきです。
- プラットフォームに依存しないデータモデル: データウェアハウスの構造をモデルとして 1 度だけ宣言し、現在利用しているデータベース向けにも、将来移行するクラウド向けにも、それぞれ最適なネイティブコードを自動生成させます。
- 過去のパッケージを持ち越さない移行: クラウド移行は、手作業で作られた何百ものレガシーロードの保守を終わらせる絶好の契機であり、古いパッケージの置き場所をクラウドへ変えるための作業ではありません。
Datavault Builder による変革
Datavault Builder は、1 つのデータモデルから SQL Server、Azure SQL、Fabric、Snowflake、Databricks、BigQuery、Oracle、PostgreSQL 向けのウェアハウスをネイティブ自動生成し、オンプレミスおよびクラウド双方のデータソースに対応した取り込み機能を標準で備えています。
- ロード処理はウェアハウス内で直接実行: ターゲットエンジンに合わせてコンパイルされたセットベースの差分 SQL を実行します。中間 SSIS サーバーも、データフローバッファの制限も、余計な ETL サーバーライセンスも不要です。
- データソースへのダイレクト接続: データベース、ファイル、REST API、NoSQL、Python ソース、Kafka ストリームからのバッチ、差分、CDC ロードに対応。高額なサードパーティ製コネクタ層は不要になります。
- プラットフォームは単なるターゲット切り替え: 今日は SQL Server 向けに生成し、明日は Fabric や Snowflake 向けに生成する。移行はコードの書き直しではなく「再生成」で完了します。
- パッケージをホストするのではなく、計画的に退役させる: モデルにマッピングされたソースから順に、クラウド VM 上でパッケージを動かし続ける必要がなくなります。
- 段階的な移行が可能: オンプレミスシステム間にとどまる処理は、移行の準備が整うまで既存の SSIS をそのまま使い続けることができます。
今すぐ判断すべきこと
移行対象のウェアハウスをターゲットにしているパッケージをリストアップしてください。それらのパッケージこそが、単純なクラウド移行によって負債をそのまま持ち越してしまう対象であり、新しいプラットフォーム向けに自動生成へ置き換えるべき最優先の候補です。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
データパイプラインを自社で完全に掌握する 3 つのステップ
-
ターゲットごとにパッケージを分類する
移行先となるクラウドウェアハウスへロードしているパッケージを特定します。それらこそが、クラウドへの単純載せ替えで負債を持ち込んでしまう対象です。
-
新プラットフォーム向けにモデルを定義する
ビジネスキー、リレーションシップ、属性を Datavault Builder のモデルに定義します。ロード用コードは Fabric、Snowflake、Databricks、BigQuery 向けに自動生成されます。
-
オンプレミスに残る処理には SSIS を継続利用する
オンプレミスの SQL Server 間で行われている処理は、モデルに移行するまで SSIS をそのまま稼働させます。一括での全面移行(ビッグバン)は不要です。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得







専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。

Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
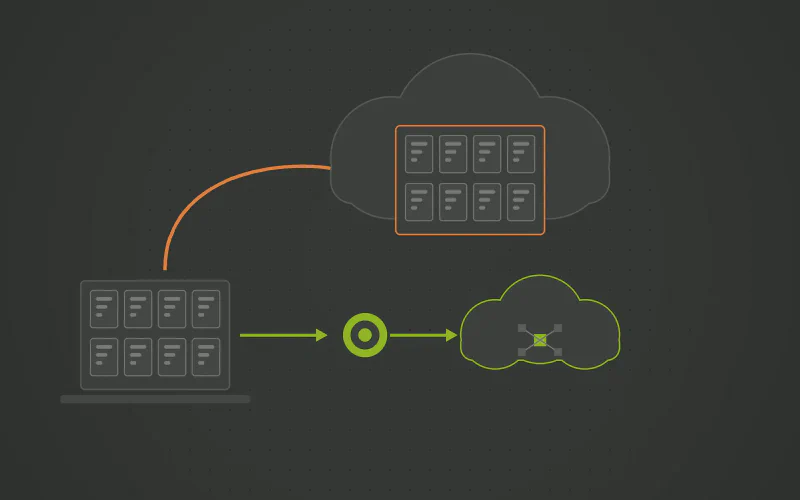
SSIS の課題:クラウドへのリフト&シフトは問題ではなく負債を移動させているだけ
SSIS 環境には、クラウド VM 上に載せ替えても決して解決しない 3 つの深刻な課題があります。誰も開きたがらないテーブルごとの大量パッケージ、DevOps が機能しないリリース手順、そして SQL Server に閉じた設計です。Azure-SSIS Integration Runtime はこれらすべてをそのままクラウドへ運びます。モデルからウェアハウスを自動生成する手法なら、それらの負債を安全に退役させることができます。
-
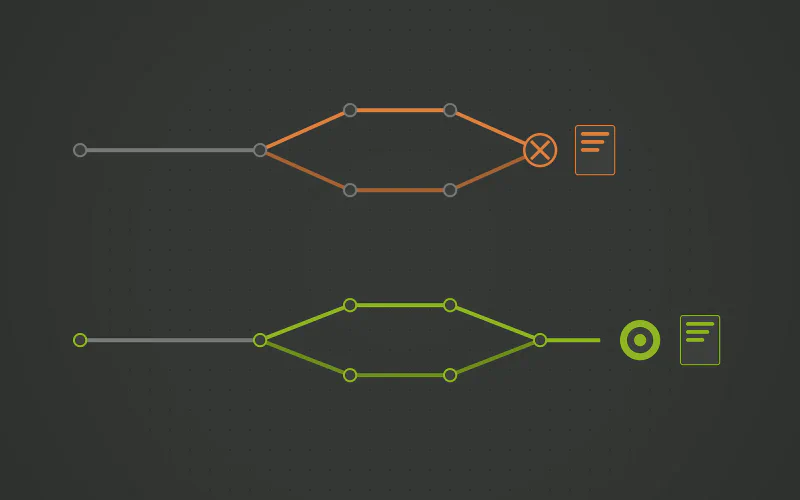
SSIS はデータスタックの中でいまだに CI/CD ができない唯一の領域ですか?
.dtsx ファイルの実体は XML であり、差分比較が困難でマージはさらに困難です。2 人のエンジニアが同じパッケージを編集すると、最終的にどちらかを作り直すことになります。環境差異は手動で保守される SSISDB の環境変数マッピングに依存しています。モダンな DevOps は SSIS プロジェクトの前で立ち往生しています。リリースは環境ごとにロールバックも含めてモデルから自動生成されるべきです。
-
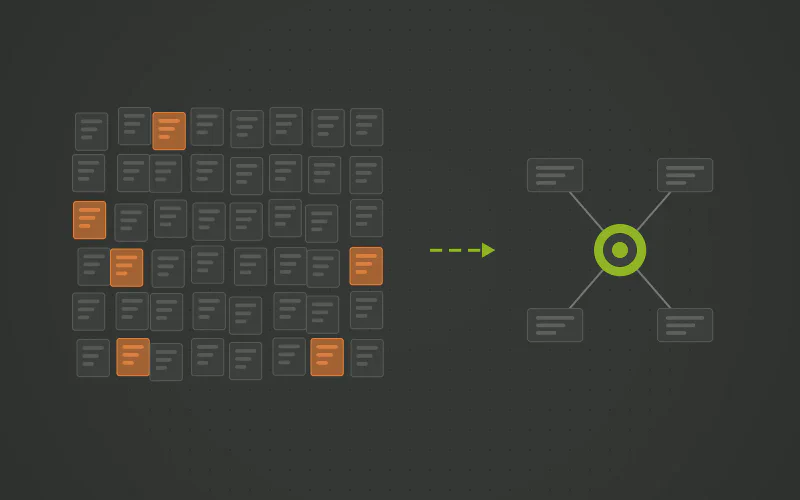
社内の SSIS パッケージが理解できるエンジニアの数を上回っていませんか?
何百もの .dtsx パッケージがテーブルごとに作成され、過去の担当者によって Visual Studio で個別に構築された結果、1 つずつ開くことしかできない状態に陥っています。カラムを 1 つ追加するだけでも、関連するパッケージを 1 つずつ開いて手動修正しなければなりません。解決策はパッケージのテンプレートを作ることではなく、SQL Server、Azure SQL、Fabric 向けにロード処理をネイティブ自動生成するモデルを導入することです。
よくあるご質問
- Azure 上でパッケージを無修正で動かせることこそが最大の問題だからです。テーブルごとの大量パッケージ、手作業で作られたデータフロー、複雑なマージ競合がそのままクラウドに持ち越されます。これは一時的な延命ブリッジに過ぎず、マイクロソフト自身の方向性もクラウド上の SSIS ではなく Fabric Data Factory です。
- はい、可能です。JDBC 経由のデータベース、ファイル、REST API、NoSQL、Python ソース、Kafka ストリームからのバッチ、差分、CDC ロードを、移行先ターゲット向けにネイティブ生成されたウェアハウスへ直接ロードできます。
- 自動生成されたデータウェアハウスは SQL Server や Azure SQL 上でもネイティブに動作するため、データベース基盤を変えずに ETL 層のみを先行して近代化できます。将来的に Fabric や Snowflake へ移行する際も、ターゲット設定を変更して再生成するだけで完了します。