ブログ — Data Vault とデータウェアハウス自動化
Data Vault 2.0、データウェアハウス自動化(DWA)、Snowflake、Databricks、および実践的なデータエンジニアリングに関する技術解説記事。
-
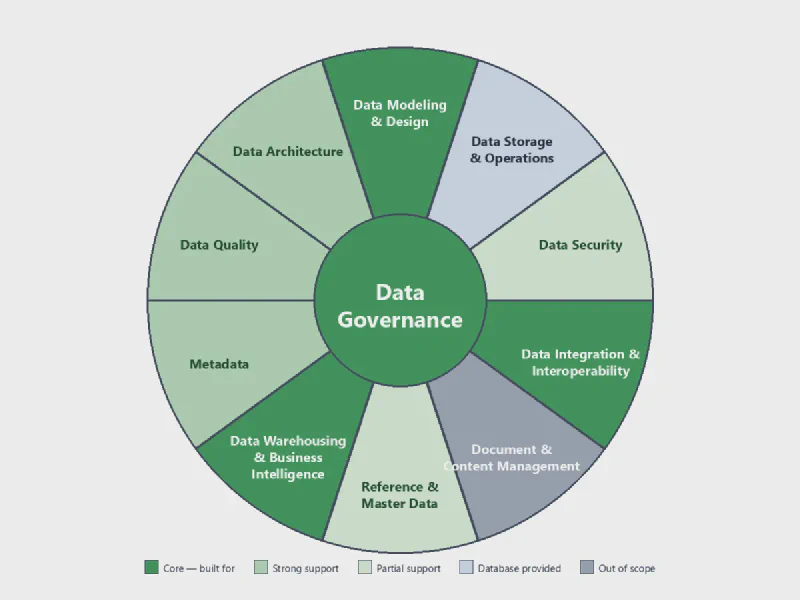
Datavault Builder と DAMA-DMBOK フレームワーク — 11 の知識領域をどう支援するか
DAMA-DMBOK の 11 の知識領域を網羅的に解説。データウェアハウス構築、統合、モデリングを劇的に容易にするために設計された Datavault Builder が各領域をどのように支援するかを Petr Beles が詳解します。
記事を読む → -
データ主権と AI 時代:エンタープライズ DWH ガバナンス
AI モデルがあらゆるデータへのアクセスを要求する時代に、いかにして自社のデータ統制を維持するか。オープンソース LLM、ガバナンスの効いた DWH、Exasol を組み合わせた実践ウェビナー。
記事を読む → -
Data Vault と Databricks メダリオンアーキテクチャの融合
Data Vault とレイクハウスは相反するアプローチだと見なされがちです。しかし本ウェビナーでは、なぜその逆こそが真実であるのかを実証します。
記事を読む → -
データがもたらすビジネス価値について私が考えていること
データプロジェクトの大半は、技術的な問題で失敗するわけではありません。価値が届くのが遅すぎるか、形が間違っているか、コストが高すぎるために失敗するのです。
記事を読む → -
ISO 27001:2022 認証取得と SOC 2 Type 2 適合保証
情報セキュリティの国際規格 ISO 27001:2022 認証および SOC 2 Type 2 適合保証を達成。Datavault Builder がエンタープライズの最高水準のセキュリティと信頼をどう保証しているかを解説します。
記事を読む → -
Flow.BI で AI 生成されたデータモデルの取り込み
Flow.BI で生成された AI メタデータを、Migration Vault アプローチを用いて Datavault Builder へと移行し、ハブやリンクのマッピング、ETL パイプラインを自動生成する実演動画。
記事を読む → -
データの統合(Integration)と結合(Unioning):ハブ設計の真価
Data Vault モデリングにおいて「ハブによる統合」と「ユニオンによる結合」を明確に区別することが、なぜ超大規模データ処理のパフォーマンスと保守性を劇的に変えるのかを解説します。
記事を読む → -
Kafka と Datavault Builder による準リアルタイム DWH 分析
IoT センサー、クレジット決済、ストリーミングデータなど、大量のリアルタイムデータを DWH でいかに効率的に処理・統合するか。Cimt AG との共同実践ウェビナー。
記事を読む → -
Snowflake Snowpark Container Services における SSO と自律運用
Snowflake の Snowpark Container Services 上で Datavault Builder を運用することで、インフラやネットワークチームに依存せず、データチーム自身が SSO 認証から開発環境構築までを完結できる理由を解説。
記事を読む → -
バイテンポラル(二重時間軸)データ処理の実践
口座残高、金融取引、保険金請求など、複雑な履歴管理が求められるシステムに不可欠なバイテンポラルデータモデリングと遡及修正の実践手法を解説します。
記事を読む → -
Snowflake Snowpark Container Services 上での Datavault Builder 稼働実演
Snowflake のマネージドコンテナ環境である Snowpark Container Services 上で、Datavault Builder をいかに簡単かつネイティブに稼働させられるかを実演したデモ動画。
記事を読む → -
モデルの直接 Git チェックイン&チェックアウト
Datavault Builder 7.1 で強化された Git 統合機能。分散開発用のサンドボックス作成、ブランチ切り替え、マージを画面上や API から直感的に操作できるアジャイル開発フローを実演。
記事を読む → -
Migration Vault(マイグレーションボルト)コンセプト
既存の Data Vault(dbt で構築されたものなど)から Datavault Builder へと移行するための専用メタデータストア概念。互換性と完全性を保ちながらスムーズに移行する手法を実演。
記事を読む → -
Talend Open Studioの代替製品との比較
Datavault Builderは、従来の無償ETLツールと同等のコストで、最大9種類のツールを置き換える多機能なデータウェアハウス自動化ソリューションを提供します。
記事を読む → -
Unified Star Schema(統合スタースキーマ)の自動化
フランチェスコ・プッピーニ(Francesco Puppini)氏とビル・インモン(Bill Inmon)氏が提唱した「Unified Star Schema(統合スタースキーマ)」を、Datavault Builderを用いてどのように自動構築・実装できるかを動画で詳しく解説します。
記事を読む → -
イェール大学の事例:データ管理を革新し、75%の工数削減とインサイト獲得の迅速化を実現
データマネジメントの自動化がもたらす圧倒的な生産性向上:イェール大学がDatavault Builderを導入し、開発工数を75%削減、データチームを拡大して分析提供を加速した事例をご紹介します。
記事を読む → -
BI-SPEKTRUM 事例紹介:SnowflakeとDatavault BuilderによるC&AのSAPデータ統合
欧州アパレル大手C&Aが、AWS、Snowflake、Datavault Builderを活用してSAPデータを統合し、モダンなグリーンフィールドDWH基盤を構築した事例を解説します(BI-SPEKTRUM掲載記事の要約)。
記事を読む → -
DDVUG Willibald ユースケース:3時間以内で構築するエンドツーエンドのデータウェアハウス
DDVUG(ドイツ語圏Data Vaultユーザーグループ)のWillibaldユースケース実演動画:Datavault Builderを使用し、2つのデータソースを統合した本格的なDWHを3時間未満で構築するプロセスを公開します。
記事を読む → -
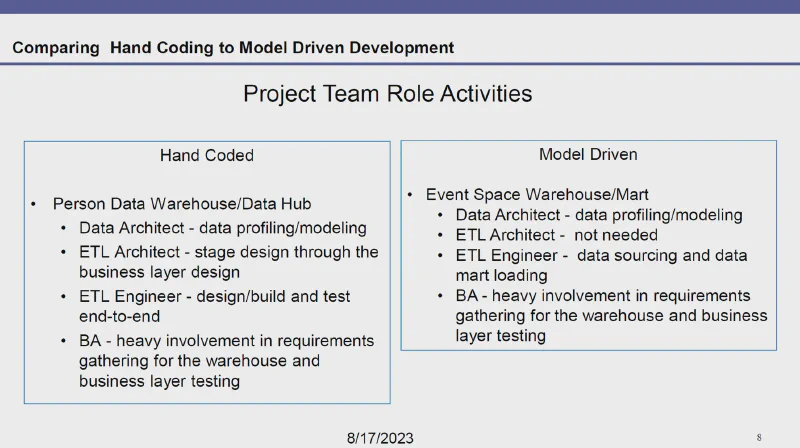
データモデリングは死んだのか?
私たちには今でもデータモデルが必要なのでしょうか?モデルの価値とは何か、なぜ過去にデータモデリングは挫折したのか、そしてモデリングを通じてどのように価値を創出できるのかを解説します。
記事を読む → -
Data Vaultにおけるバイテンポラルデータ:インスクリプションタイム(登録時刻)の扱い方
Data Vaultにインスクリプションタイム(登録日時)を用いてバイテンポラル(二重時間軸)データをロードする方法:設計パターン、落とし穴、銀行業務における実践例を徹底解説。
記事を読む → -
Data Vault vs. Data Mesh — 対立か、共存か?
Data Mesh があるのに Data Vault はまだ必要なのか? Petr Beles が、Data Mesh と Data Vault、そして自動化がなぜ完璧な共存関係にあるのかを徹底解説します。
記事を読む → -
SnowflakeとDatavault BuilderによるCI/CDパイプラインの実現
Snowflakeのゼロコピークローニング機能とDatavault Builderを連携させ、データウェアハウスにおける強力なCI/CD(継続的インテグレーション/デリバリー)環境を構築する方法を解説します。
記事を読む → -
等価結合(Equi-Join)は常に優れているのか?
「INNER JOIN(等価結合)は常にLEFT JOINより優れている」という通説は本当か?Snowflake上で3000万行のデータセットを用いたベンチマーク検証結果を解説。
記事を読む → -
第3正規形(3NF)とData Vault:恐れる必要はまったくない
Datavault Builderは第3正規形(3NF)をサポートしているか?Data Vaultコアから決定論的に3NFインターフェースビューを自動生成する方法を解説します。
記事を読む → -
DWHにおける時間性(Temporality)第4部:SCD Type 2ディメンションの出力とPIT/PIT+
KimballスタイルのSCD Type 2ディメンションをData Vaultから出力する実践手法:PITテーブル、PIT+の設計、複数ハブをまたぐテンポラルJOINの極意を解説。
記事を読む → -
DWHにおける時間性(Temporality)第3部:時間軸の出力要件
レポートで時間軸を実際に出力すべきケースとは何か?顧客履歴(1d)、不正検知と訂正履歴(2d)、認識状態の比較再現(3d)の各ユースケースと実装パターンを解説。
記事を読む → -
DWHにおける時間性(Temporality)第2部:時間的複雑性の排除
Data Vaultにおける時間的複雑性をいかに排除・簡素化するか。2d属性化、テンポラル・インスタンス・ハブ、トランザクションへの属性インスタンス化という3大戦略を解説。
記事を読む → -
DWHにおける時間性(Temporality)第1部:定義と課題
データウェアハウスに存在する3つの時間軸(有効期間、登録日時、ロード日時)、タイムスライス、SCD Type 2、およびas-is/as-was/as-ofの概念と関係性を徹底解説。
記事を読む → -
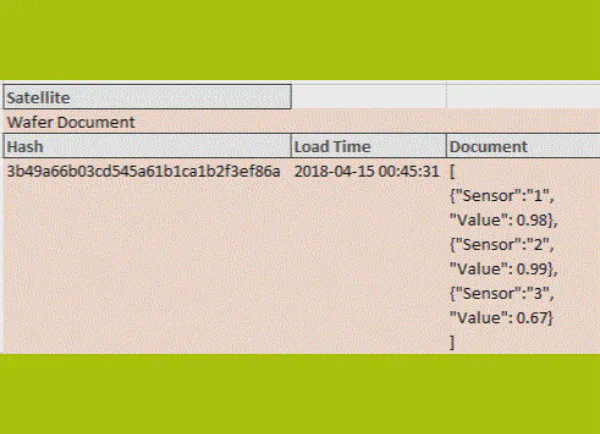
Data Vaultにおけるマルチアクティブサテライトの考察:ドキュメントサテライトによる解決策
Data Vaultにおけるマルチアクティブサテライト(MAS)の課題と、JSON型を活用したドキュメントサテライトによるスマートな実装パターンとトレードオフを解説。
記事を読む → -
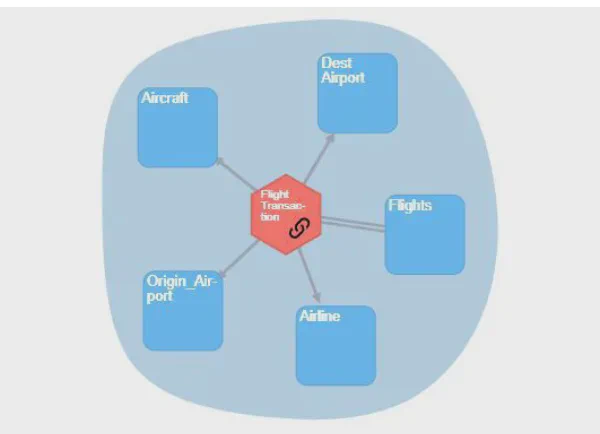
Data Vaultにおけるリンクの考察:トランザクションを表現するリンクのモデリング
Data Vaultにおけるトランザクション(取引・イベント)を表現するリンクの設計パターン、粒度の課題、そして「Keyed-Instance Hub」を用いたスマートな解決策を解説。
記事を読む → -
Qlik
Qlik アプリと Power BI レポートで数値が食い違っていませんか?
Qlik も Power BI も計算自体は間違っていません。問題は、各ツールが独自のロードロジック、独自の定義、独自のリネージを持っているため、同じ指標が 2 回別々に計算され、誰もその差異を照合できない点にあります。ロジックは両ツールが参照する単一のガバナンスの効いたウェアハウスモデルに集約されるべきです。
記事を読む → -
Tableau
Tableau Server 内で同じ指標の異なるバージョンが乱立していませんか?
公開された各 .tdsx ファイルは、作成された時点ではどれも合理的な判断によるものでした。しかし結果として、同じ指標に対して社内に何百通りもの独自定義が存在し、どれが正しいのか誰も判断できない状態に陥っています。
記事を読む → -
Power BI
Power BI レポートごとに同じ指標の数値が食い違っていませんか?
財務、営業、運用部門がそれぞれセマンティックモデルを構築し、各モデル内では整合性が取れている。しかし、同じ「売上」でも定義が部門間で合意されたことは一度もない。数値の不一致の原因と、根本的な解決策を解説します。
記事を読む → -
Qlik
Qlik のロードスクリプトごとに同じデータクレンジングを繰り返していませんか?
同じマッピングテーブル、文字列のトリミング処理、重複排除ロジックが、あらゆるアプリや QVD レイヤーで何度も書かれ、コピー同士の定義が徐々に乖離していく。データクレンジングがスクリプトごとに繰り返されるのは、上流のデータウェアハウスがそれを一元的に解決していないからです。
記事を読む → -
Qlik
Qlik のセット分析(Set Analysis)式が長すぎて重くなっていませんか?
セット分析は、前年同月比などの真の比較集計を行うための強力な機能です。しかしアプリ内に存在する長大な計算式の多くは、モデル側に履歴、フラグ、統一された粒度が存在しないため、チャートが選択操作のたびにそれらを再構築していることが原因です。
記事を読む → -
Tableau
Tableau の LOD 表現が複雑すぎて誰も手を付けられなくなっていませんか?
FIXED、INCLUDE、EXCLUDE は、本来異なる粒度(Grain)が混在する集計を行うための強力な機能です。しかしワークブック内にある LOD 表現の大半は、データウェアハウス側でデータの粒度が揃っておらず、履歴が保持されていない穴埋めとして使われています。
記事を読む → -
Power BI
Power BI の DirectQuery レポートがクリックのたびに重くありませんか?
DirectQuery や Direct Lake はリアルタイムな最新データを提供すると謳われています。しかし実際に起きるのは、表示に 30 秒かかるビジュアルと、誰も説明できない高額なクラウドアカウントの請求書です。問題は DirectQuery モード自体ではなく、その下にあるスキーマ構造にあります。
記事を読む → -
Qlik
Qlik アプリ内で意図しない合成キーが勝手に生成されていませんか?
合成キー(Synthetic Key)や循環参照(Circular Reference)は、Qlik が与えられたテーブル構造を愚直に関連付けた結果として発生します。データが適合ディメンションや適切な主キーを持たずに届くため、アプリごとにそれらを無理やり作り出さざるを得ないことが根本原因です。
記事を読む → -
Qlik
Qlik のデータ増加に伴いリロードがメモリ不足で落ちていませんか?
Qlik のインメモリエンジンが高速なのは、全データが RAM 上に展開されるからです。しかし、上流のデータウェアハウスが事前に集計や変換を行わず、生の明細行と重いデータ加工をそのまま Qlik に抱え込ませると、リロードはメモリ不足で失敗し、アプリ全体が著しく低速化します。
記事を読む → -
Tableau
Tableau の抽出更新がタイムアウトや遅延を繰り返していませんか?
Tableau の Backgrounder がタイムアウトし、.hyper ファイルが肥大化し続け、ダッシュボードには昨日の古いデータが表示される。抽出が重い真の原因は、上流で集計されていない生のトランザクション行を Tableau 側で抱え込んでいることにあります。
記事を読む → -
Power BI
Power BI の DAX メジャーが長すぎて保守不能になっていませんか?
CALCULATE と FILTER が 200 行にも連なる DAX 式は、高度なスキルの証拠ではありません。多くの場合、上流のウェアハウスが必要なサロゲートキー、変更履歴、適切な粒度を提供してくれなかったことの表れです。
記事を読む → -
Tableau
Tableau ダッシュボードのフィルターを切り替えるたびに待たされていませんか?
フィルターを 1 つクリックするたびに「クエリを実行中...」が 20 秒間表示される。Tableau の描画エンジンが遅いのではありません。データベース側に、即答できない構造の質問が投げかけられていることが原因です。
記事を読む → -
Power BI
Power BI の深夜のスケジュール更新が失敗し続けていませんか?
スケジュールされた定期更新がタイムアウトし、Power Query がメモリ不足エラーを起こし、朝ダッシュボードを開いたユーザーからの指摘で初めて障害に気づく。その原因は Power BI 自体ではなく、Power BI に背負わせているデータ処理そのものにあります。
記事を読む → -
dbt
dbt のトレードオフ:モデル乱立、隠れた TCO、そして自動モデリングへの転換
dbt は SQL にソフトウェアエンジニアリングの手法をもたらし、多くのチームに支持されました。しかしその代償として、コード量、運用コスト、コンピュート費用が肥大化し続ける変換レイヤーを抱え込むことになり、取り込みツールも依然として別製品のままです。自動生成される Data Vault は、そのレイヤー全体をコードベースから取り除きます。dbt を完全に置き換えることも、共存させることも可能です。
記事を読む → -
Azure Data Factory
Azure Data Factory の課題:UI パイプラインと Spark 変換の隠れたコスト
Azure Data Factory は Azure 内部のデータ転送層としては優れていますが、データウェアハウスを保持する場所としては不向きです。モデリングや変換基盤として使ってしまうと、誰も解読できないキャンバス、ARM テンプレートのデプロイ失敗、1 行の SQL で済む処理のための Spark クラスターなど、多くの摩擦が生じます。そして何より、それらのパイプラインはすべて Azure 専用に縛られています。
記事を読む → -
dbt
dbt 導入後もデータ取り込み(インジェスチョン)に悩まされていませんか?
dbt は意図してデータ変換(Transform)に特化したツールとして設計されています。生データがすでにウェアハウス内に存在することを前提としているため、データのランディングには別の製品と別個の請求書が必要になります。Fivetran と dbt Labs が合併した現在でもこの構造は変わりません。取り込みとモデリングを 1 箇所で完結させるプラットフォームなら、二重契約なしにこのギャップを埋めることができます。
記事を読む → -
SSIS
SSIS の課題:クラウドへのリフト&シフトは問題ではなく負債を移動させているだけ
SSIS 環境には、クラウド VM 上に載せ替えても決して解決しない 3 つの深刻な課題があります。誰も開きたがらないテーブルごとの大量パッケージ、DevOps が機能しないリリース手順、そして SQL Server に閉じた設計です。Azure-SSIS Integration Runtime はこれらすべてをそのままクラウドへ運びます。モデルからウェアハウスを自動生成する手法なら、それらの負債を安全に退役させることができます。
記事を読む → -
dbt
dbt の実行処理がウェアハウスのコンピュート費用を密かに押し上げていませんか?
dbt はすべての処理をウェアハウス内で実行するため、差分更新で済む場所で全件リフレッシュを行ったり、毎晩テーブルを全件再構築したりしていてもエラーにはならず、消費クレジットとして静かに跳ね上がります。dbt において増分更新ロジックは手書きのオプションに過ぎません。一方、自動生成される Data Vault では、すべてのロード処理が最初から差分処理として構築されます。
記事を読む → -
Azure Data Factory
Azure Data Factory の Mapping Data Flow のコストがデータ価値を上回っていませんか?
Mapping Data Flow はマネージド Spark クラスター上で実行され、起動に数分を要し、vCore 時間単位で課金されます。夜間の大規模なデータ変換であれば妥当ですが、数十万行程度の処理のためにクラスターを起動するのは、ウェアハウス内の単一の SQL 文で済む作業に対して過剰なコストを払っていることになります。
記事を読む → -
dbt
dbt プロジェクトで誰も全容を説明できないモデルが乱立していませんか?
ref() 関数のおかげで、1 行書くだけで誰でも簡単に新しいモデルを作成できます。その結果、ガバナンスの効かない何百もの SQL ファイルがプロジェクト内に蓄積されます。上流のビジネスキーを 1 つ変更すると、その影響を受けるモデルを探し回る羽目になります。解決策はテストを増やすことではなく、構造を手作業で蓄積する代わりにモデルから自動生成することです。
記事を読む → -
SSIS
SSIS はクラウドデータウェアハウスの境界で力尽きていませんか?
SSIS はオンプレミスの SQL Server インスタンス間でデータを移動するために設計されました。ウェアハウスを Fabric、Snowflake、Databricks、BigQuery へ移行する際、パッケージをクラウド上の Azure-SSIS IR に載せ替えるか、サードパーティ製コネクタを購入するか、全面再開発するかの選択を迫られます。新しいプラットフォーム向けにコードをネイティブ自動生成するモデルこそが、レガシーパッケージを持ち込まずに済む第 4 の選択肢です。
記事を読む → -
dbt
dbt の運用コスト:増えているのはアカウント費ですか、それとも人件費ですか?
dbt Core は利用自体は無料ですが、運用には莫大な人件費がかかります。dbt Cloud は運用が容易ですが、開発者アカウント数と利用量に応じた従量課金が発生します。どちらの道を選んでもデータ変換層のコストはチーム規模に比例して増大します。解決策は、定型的なコードをモデルから自動生成し、手書きコードそのものを削減することです。
記事を読む → -
Azure Data Factory
Azure Data Factory のリリースが ARM テンプレートの修正作業に追われていませんか?
ビジュアルエディタの裏側で、Azure Data Factory の実体は JSON です。パイプライン、データセット、リンクサービス、そしてそれらをデプロイする ARM テンプレートで構成されています。開発環境から本番環境へリリースする際、パラメータファイルやグローバルパラメータの調整に追われ、わずか 1 つのデータ型の不一致でデプロイが中断します。リリースはロールバック機能も含めてモデルから自動生成されるべきです。
記事を読む → -
Fivetran
Fivetran のコストとスキーマの課題:データ取り込みの摩擦を自動モデリングで解消
設定不要ですぐに動くプラグ&プレイの ELT は、導入当初は迅速ですが、長期的には制御が困難になります。時間の経過とともに損なわれるのは「パイプラインの費用」と「データの形状を誰が決めるのか」という主導権です。自動化された Data Vault レイヤーは、稼働中のコネクタを維持したまま、これら両方の主導権を取り戻します。
記事を読む → -
SSIS
SSIS はデータスタックの中でいまだに CI/CD ができない唯一の領域ですか?
.dtsx ファイルの実体は XML であり、差分比較が困難でマージはさらに困難です。2 人のエンジニアが同じパッケージを編集すると、最終的にどちらかを作り直すことになります。環境差異は手動で保守される SSISDB の環境変数マッピングに依存しています。モダンな DevOps は SSIS プロジェクトの前で立ち往生しています。リリースは環境ごとにロールバックも含めてモデルから自動生成されるべきです。
記事を読む → -
Fivetran
Fivetran のスキーマ仕様により、ロードのたびに手動でデータ再加工を強いられていませんか?
Fivetran は各ソースを標準化された独自のスキーマで出力します。その結果、ビジネスキーの統合、カスタムフィールド、レガシー構造への対応を、ロード後の SQL スクリプトで手作業で加工しなければならず、コネクタの仕様変更で容易に破損します。解決策はより優れたスクリプトを書くことではなく、データの形状を自ら掌握するモデルを持つことです。
記事を読む → -
Azure Data Factory
Azure Data Factory のキャンバスが開発チームの手に負えなくなっていませんか?
ドラッグ&ドロップのパイプラインは構築は迅速ですが、変更には多大な時間がかかります。数十のアクティビティを超えると、キャンバス自体がドキュメントと化し、配線作業がロジックを覆い隠します。解決策はキャンバスを整理することではなく、パイプラインを自動生成するモデルを導入することです。
記事を読む → -
Fivetran
Fivetran の請求額がソーステーブルの更新頻度によって急上昇していませんか?
Fivetran は Monthly Active Rows(MAR:月間アクティブ行数)に基づいて課金されます。上流での一括更新やスキーマ移行が行われると全行が再処理対象となり、請求額が跳ね上がります。データ行自体が悪いわけではありません。自前で再処理するデータに対して行単位で課金される料金モデルこそが問題なのです。
記事を読む → -
SSIS
社内の SSIS パッケージが理解できるエンジニアの数を上回っていませんか?
何百もの .dtsx パッケージがテーブルごとに作成され、過去の担当者によって Visual Studio で個別に構築された結果、1 つずつ開くことしかできない状態に陥っています。カラムを 1 つ追加するだけでも、関連するパッケージを 1 つずつ開いて手動修正しなければなりません。解決策はパッケージのテンプレートを作ることではなく、SQL Server、Azure SQL、Fabric 向けにロード処理をネイティブ自動生成するモデルを導入することです。
記事を読む →








該当する記事はまだありません。