Data Vault vs. Data Mesh — 対立か、共存か?
Data Mesh があるのに Data Vault はまだ必要なのか? Petr Beles が、Data Mesh と Data Vault、そして自動化がなぜ完璧な共存関係にあるのかを徹底解説します。
「Data Mesh があるのに、私たちはまだ Data Vault をやるべきなのでしょうか?」 ここ数週間から数ヶ月の間、私はこの非常に興味深い質問を何度も受けてきました。そこで本稿では、私自身の理解と考えを整理してお伝えしたいと思います。異なる見解をお持ちの方は、ぜひ LinkedIn で気軽にご連絡いただき、ディスカッションさせていただければ幸いです。もし Data Mesh の概念のどこかに誤解があれば、ぜひご指摘ください。
私の主張の前提として、これまでの私の経歴と、何が私の考えを形作ってきたのかをお伝えしておくと分かりやすいかもしれません。私は 2000 年からデータの世界で仕事をしてきました。Sybase クライアントが Oracle へ移行し、その Oracle クライアントが Snowflake などのクラウドデータベースへと移行していく技術的変遷を目の当たりにしてきました。また、インモン流の第 3 正規形(3NF)モデリングがディメンショナルモデリングに置き換わったり補完されたりし、さらには Data Vault モデリングが急速に普及していく歴史も経験してきました。
私は常に、Data Vault モデリングを「インモン流 3NF モデリングの進化形」として捉えており、多くの場合はレポーティング用途のディメンショナル出力と組み合わせて活用されるものと考えています。
過去 22 年間にわたり、ビジネスユーザーがより迅速なレポート提供やデータの分かりやすさを繰り返し求めてきた姿を見てきました。そうした要求へのプレッシャーが、時に新たなテクノロジーや新たなモデリングアプローチの台頭へとつながってきました。
また別の場面では、「どれだけ中央(専門チーム)に集約し、どれだけ分散化すべきか」という組織論の議論を引き起こしました。この中央集権と分散の間の緊張関係は、決して今に始まった新しいものではありません。
私の理解、そして個人的な見解としては次の通りです:Data Mesh とは、中央集権型アプローチを採用する特定の企業において、中央データチームがボトルネックになってしまうという課題に対する答えです。 私はその状況を痛いほどよく理解しています。私自身が現場でその状況に直面してきましたし、率直に言えば、私自身もその問題の一部でした。
その結果として、私は Zhamak Dehghani 氏の著作で示されている多くの視点に強く共感しています。ただし、このアプローチが最も威力を発揮するのは、各ドメインに専門のデータスペシャリストを配置できるだけの豊富なリソースを持った巨大エンタープライズ企業であると考えています。
私の主張は、中堅企業や一般的な大企業にとっては、代替ソリューションとして「モデル駆動型の自動化」を活用することで中央チームのボトルネックを解消し、中央集権チームの恩恵を最大化する方がより大きな投資対効果を得られるということです。ここで私が Datavault Builder チームで働いており、「DWH の自動化こそが私たちの専門領域である」というポジショントークが含まれ得る点は明記しておかなければなりません。
それでも、自動化だけでは完全なスケールアウトが達成できないような超大企業においては、「Data Mesh」で提唱されている形式化された分散アプローチが最適な選択肢となるでしょう。以下では、この文脈における Data Vault と Data Mesh の関係について掘り下げていきます。
Data Vault vs. Data Mesh?
記事を読むよりも動画で視聴されたい方は、Knowledge Gap カンファレンスの録画動画をこちらからご覧いただけます。
私が読み解いた内容を大幅に要約すると、Data Mesh は「全社エンタープライズデータモデルは死んだ」と主張しています。データモデリングと「データフロー」の実装を各ドメインに分割し、独立した自律的チーム(ドメイン)に委譲すべきだという考え方です。
では、これは Data Vault が方程式から消え去ることを意味するのでしょうか? 私はそうは思いません。
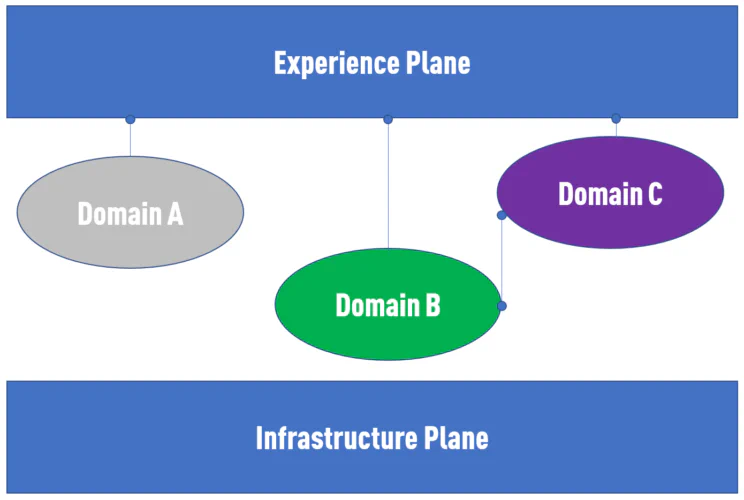
インフラストラクチャと Mesh の「エクスペリエンス層(Experience Plane)」の間に、さまざまなデータプロダクトプロバイダーが存在しているのが分かります。Data Mesh は、ドメインチームに対して「それらをどう作るべきか」という具体的な実装手順までは規定していません。多くの場合、この領域こそが「自動化された Data Vault アプローチ」を適用するのに最も理想的な場所であると私は主張します。
なぜでしょうか? 過去に手書き ETL アプローチで身動きが取れなくなった経験がある場合、それらをより小さなドメインに分割すれば、中央データチームのスケーラビリティ問題は緩和され、一部の複雑さは軽減されるかもしれません。しかし、ドキュメントの欠落や膨大な手作業といった根本的な問題は依然として残ります。
実装されたビジネスロジックを理解するために、過去の複雑な ETL フローをリバースエンジニアリングしなければならなかった経験がある方なら、私の言わんとすることがお分かりいただけるはずです。
モデル駆動型アプローチは、その逆からスタートします。「データがそもそも何を意味しているのか」を理解することから始めるのです。過去のエンタープライズデータモデルにも手痛い失敗体験がありました。作成に何ヶ月もかかり、理解するのに博士号が必要なほど難解で、抽象的すぎてデータチームから無視されてしまうようなモデルです。こうした苦い経験から、データモデル自体を完全に撤廃したがる人々が多いのも理解できます。
しかし、私たちはやはりデータモデルを必要としています。データモデルは計り知れない価値をもたらし、多くの問題を解決してくれるからです。必要なのは、モデルに対する「正しいアプローチ」です。
Data Vault は、エンティティ間の「疎結合(Loose Coupling)」を採用することで、3NF エンタープライズデータモデルの抱えていた硬直性を解決しました。データモデルを小さく始め、すぐに本番実装し、後から段階的に拡張していくことが可能です。このアプローチにより、早期にビジネス価値を創出し、真のアジリティを手に入れることができます。
一方で Data Vault のデメリットは、徹底した正規化(ハイパーノーマライゼーション)によって大量の技術的オブジェクトが生成される点です。結果として、各ドメインチームで Data Vault を手作業で実装しようとすると大量のデータエンジニアが必要になり、チームごとに実装手法がバラバラになってしまいます。また、サイドカー機能を付け足そうとするたびに、ドメインごとに車輪の再発明を繰り返すことになります。
ここで、私のお気に入りのテーマに戻ります。「自動化」です。 自動化を活用することで、データモデルを実行可能な実稼働コードへと自動変換し、データプロダクトの実装に必要な作業量と専門知識をドメイン内で劇的に圧縮できます。
また、Zhamak Dehghani 氏が定義した要件の多く — 明確なデータリネージの確保、データの履歴管理の確立など — も自動化によって完全にクリアできます。
例えば Datavault Builder を使用すれば、自動化されたインフラ、サイドカーを注入するためのインターフェース、そして高度に正規化された Data Vault コアに対する非正規化ビューとしての「データプロダクト」を直感的に定義するビジュアルツールが手に入ります。
さらに、モデルは Git-flow に基づく標準的なソフトウェア開発アプローチでバージョン管理されるため、モデルやデータプロダクトのデプロイ時に生じるあらゆる競合を解消できます。
Docker デプロイメントと提供される REST API を通じて、CI/CD ワークフローも極めてシンプルに構築可能です。
自動化された Data Vault はモデル駆動型であるため、書籍で語られているような設計時および実行時のあらゆるメタデータを、手作業での開発を一切行わずに自動生成・照会できます。
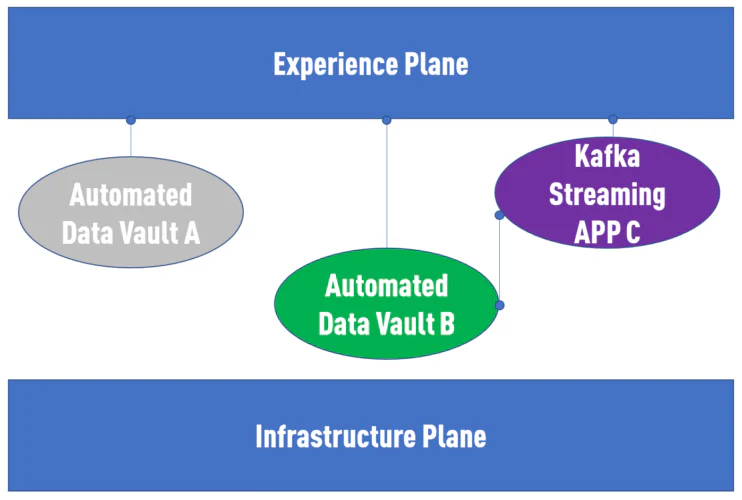
結論として:Data Mesh + Data Vault こそが真の答えです。より正確に言えば、「Data Mesh + Data Vault + 自動化」です。
中央集権型 vs. 分散型データモデル
書籍『Data Mesh』では、具体的な実装の詳細についてはあえて抽象的に留められています。これは決して批判ではありません。多様な実装の可能性を開くビジョンを示すためには、そうあるべきだからです。しかし私の立場からは、常に特定のアーキテクチャの具体的実装と、それが細部に至るまでどう機能するかを徹底的に考え抜きます。したがって、このセクションでは「それをどう実装し、実際に運用可能にするか」について論じます。
モデリングの責任を複数のチーム — Data Mesh の言葉で言えばドメイン間 — で分担できることは理解できます。私たちは、全社基盤チームと各国固有の要件を熟知したローカルデータチームを持つグローバル企業などで、長年にわたり同様の分担を行ってきました。
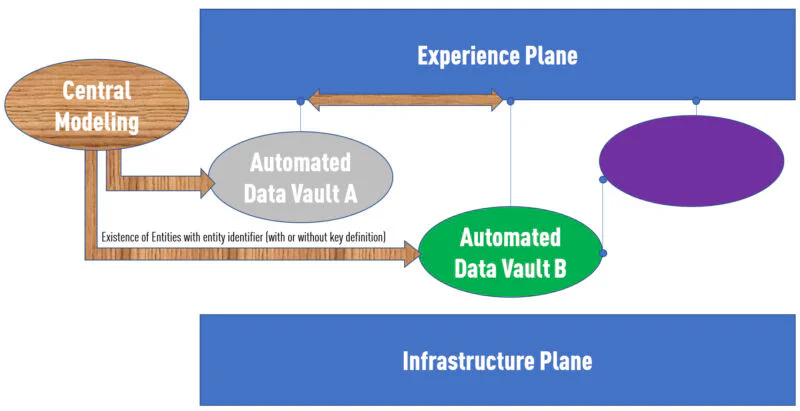
中央チームは「顧客」や「商品」といった全社共通の重要エンティティを定義します。これを聞いて、「せっかく取り払おうとしていた中央集権のボトルネックをまた作るのか!」という反論が聞こえてきそうです。
どうか最後まで聞いてください。私はそれらのオブジェクトの「物理実装」まで中央で抱え込むべきだと主張しているのではありません。「それらのオブジェクトが存在する」という概念的な定義のみを中央で管理するのです。ER 図の世界でキャンバス上にエンティティを描くこと、Data Vault の世界で言えば「ハブ」に相当します。そして、すべてのドメインで共通認識できる一意の識別子(ID)を付与します。Datavault Builder ではスマートキーを用いてこれらの概念を識別しますが、技術的な ID を採用することも可能です。
これらの共通概念の存在を確立した上で、その「プロトタイプ」を各ドメインへと配布します。各ドメインは Datavault Builder の自律インスタンスを実行します。ドメインチームは、自分たちのインスタンス内で、その概念をどのようなデータで満たすか(どの顧客サブセットを自分たちの「顧客」に含めるか)、どのような属性を保持し、どのようなビジネスルールを適用するかを自律的に決定します。
中央で存在を定義し、その定義を各データドメインへ配布するこのプロセスは、Datavault Builder 内で完全に自動化できます。中央モデルとローカルモデルが、Git のプロセスを通じて自在にブランチ作成およびマージできるように設計されているからです。この仕組みにより、中央の定義作業がドメインチームの足を引っ張ることは一切なく、余計な作業を強いることもありません。
それどころか、あるドメイン内の概念を他ドメインでも再利用すべきだと判断した場合(他ドメインの概念からリンクさせたい場合など)、それを中央モデルへと追加提案し、他チームへ自動配布することも可能です。
データドメイン間をいかに技術的に結合(Join)するか
論理的な観点から異なるデータプロダクトをどう結合するかを理解したところで、残る問題は「それを技術的にどう実現するか」です。書籍『Data Mesh』では、オブジェクト間の URI リレーションシップの利用が提案されています。このアプローチは小規模なクエリには機能するかもしれませんが、膨大なデータ量を扱う場合、パフォーマンス面で極めて深刻な課題に直面します。
しかし、Datavault Builder はほとんどの層において ELT 方式を採用しており、すべての成果物は仮想インターフェース(ビュー)を伴うデータベース層に直接配置されます。
これは何を意味するかというと、異なるデータドメインが独立した別々のデータベース上で Datavault Builder インスタンスを稼働させていたとしても、基盤となるテクノロジー(Snowflake、Azure Synapse、SQL Server、Oracle 等)が共通であれば、クロスデータベースクエリを用いて瞬時にドメイン間結合を実行できるということです。これらのクロスデータベース結合は、個々の Datavault Builder インスタンスの外側にある Data Mesh のエクスペリエンス層によって駆動されます。
仮に各ドメインのインスタンスが異なるデータベース技術を採用している場合や、非リレーショナルデータと結合したい場合は、Denodo のようなデータ仮想化製品を連携させることで解決できます。
私の主張の要点は、ドメイン内で稼働する各 Datavault Builder インスタンスが、データプロダクトをデータベースインターフェース(API としても提供可能)として明確に公開し、すべてのメタデータと合意されたキーカラム名をエクスペリエンス層へ自動提供する点にあります。これにより、エクスペリエンス層はその強みを最大限に発揮し、データベースや仮想化エンジンを通じて各ドメインを統合し、JDBC/ODBC や API 経由でエンドユーザーへ高品質なデータを届けられるのです。
Datavault Builder が Data Mesh 実装に最適な理由
- クラウドネイティブ: 標準化されたインフラストラクチャ層の上でシームレスに稼働
- 自動化されたインフラセットアップ: Docker デプロイメントにより、設定ファイルベースで新たな環境を瞬時にプロビジョニング
- API 駆動型 CI/CD: すべてのデプロイおよびリリース操作を REST API から自動トリガー可能
- モデル駆動型自動化: データドメイン側に高度なコーディング専門スキルが不要
- Git Flow 完全対応: データモデルを自在にブランチ&マージでき、ドメインチーム内での安全な並行分散開発を実現
- 中央と分散のハイブリッドモデル: コア要素を中央で定義し、ローカルのドメイン駆動インスタンスへと自動配布する標準機能を内蔵
- ビジュアルなデータプロダクト構築: 正規化されたコアデータストアから、ビジネス向けデータプロダクトを視覚的に定義・生成
- 列レベルの自動データリネージ
- 生きたドキュメントの全自動生成
- すべての運用メトリクスをリアルタイムに把握可能
- 小さく始めて継続的にドメインモデルを拡張できる Data Vault の俊敏性
貴社のデータ環境に Datavault Builder がどのように適合するか確認してみませんか? 無料の個別デモを予約する — 貴社固有のユースケースに合わせて具体的なアーキテクチャをご案内します。