Azure Data Factory の Mapping Data Flow のコストがデータ価値を上回っていませんか?
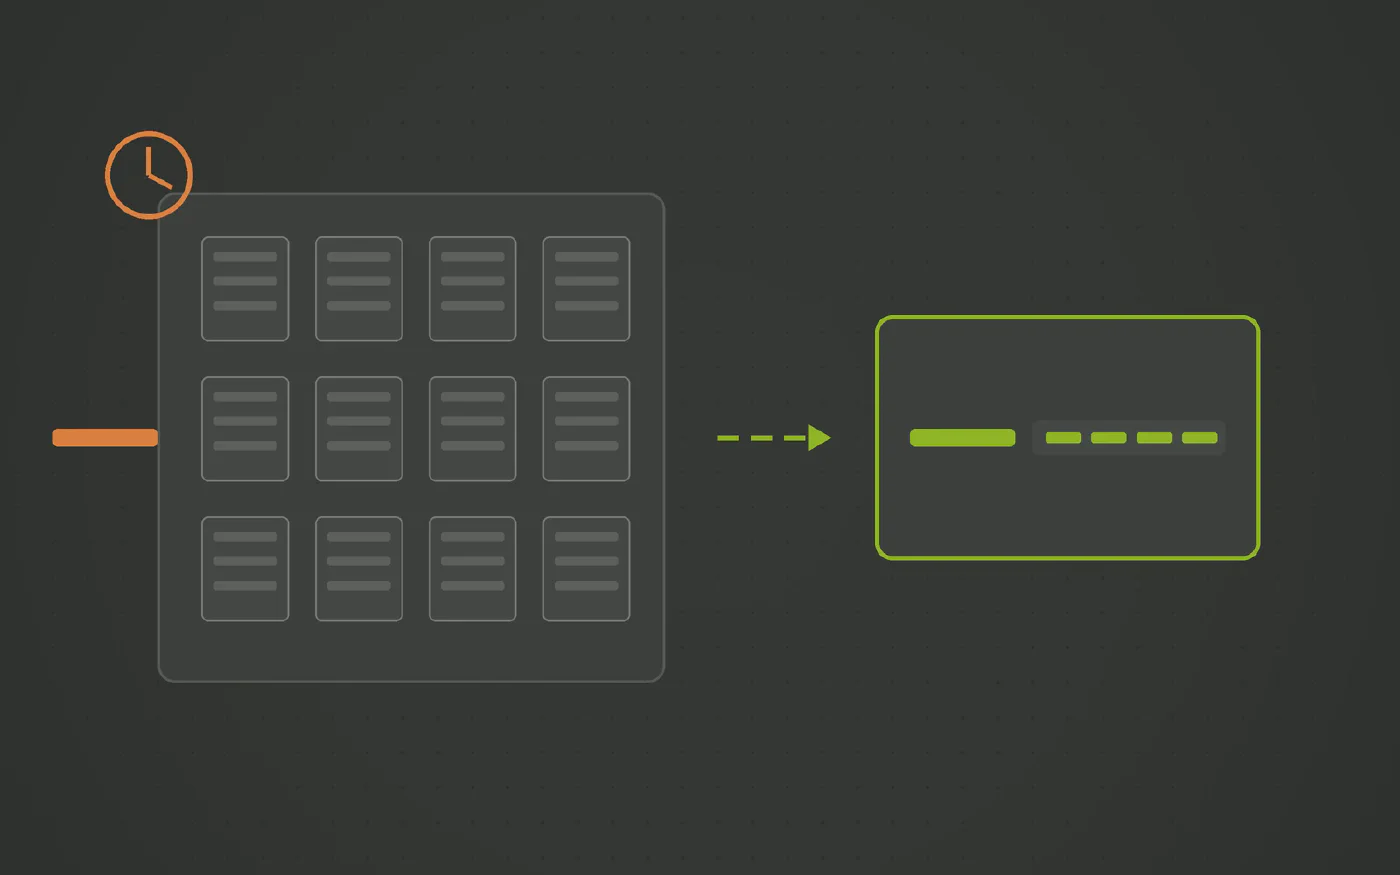
Mapping Data Flow はマネージド Spark クラスター上で実行され、起動に数分を要し、vCore 時間単位で課金されます。夜間の大規模なデータ変換であれば妥当ですが、数十万行程度の処理のためにクラスターを起動するのは、ウェアハウス内の単一の SQL 文で済む作業に対して過剰なコストを払っていることになります。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション









このような課題はありませんか?
- 夜間の比較的小規模なデータ変換処理が、Data Factory の請求書で最大の項目として計上されている。
- Data Flow を実行するたびに、実際の処理が始まる前にクラスターの起動待ちで数分間待たされる。
- 待ち時間を避けるために Integration Runtime のクラスターを起動したまま(TTL 設定)にしているため、アイドル中も課金が発生している。
- コストを削減するために誰かが手動で書き直した結果、同じ変換処理が Data Flow とストアドプロシージャの双方に二重存在している。
Mapping Data Flow は、Azure Data Factory でノーコードのデータ変換を実現する中核機能であり、キャンバスの裏側ではマネージド Spark クラスターが稼働しています。クラスターが起動し、フローが実行され、クラスターが停止するまでの間、vCore 時間単位で課金が発生します。テラバイト級の大規模なデータ変換であれば、このコストは十分に正当化されます。しかし、一般的なデータウェアハウスのロード処理の大半において、それは 1 行の SQL 文で瞬時に終わる処理のために、わざわざ専用の巨大な分散クラスターを立ち上げているようなものです。
コストが膨張する理由
- 実行するたびにクラスター起動費用が発生する: クラスターの立ち上げには数分かかり、処理対象が 1,000 万行であってもわずか 1 万行であっても、その起動時間分の料金が確実に請求されます。
- ウォームスタンバイはコストの性質を変えるだけで削減にはならない: Integration Runtime に TTL(Time to Live)を設定してクラスターを維持すれば待ち時間はなくなりますが、今度はアイドル中のクラスター費用を支払い続けることになります。
- 小規模なロード処理が大半を占めている: データウェアハウスのロード処理の多くは、小規模かつ高頻度です。これはクラスターごとの時間課金モデルにとって、最もコストパフォーマンスが悪化するパターンです。
- データはすでにデータベース内に存在している: ウェアハウス内のリレーショナルデータを一度外部の Spark に読み込み、変換処理を行った上で、再びウェアハウスに書き戻しています。ウェアハウスのエンジン自体がその場で直接処理できるにもかかわらず、無駄なデータ転送とコンピュートを発生させています。
これらは Data Flow 自体の欠点ではありません。Spark は高負荷なビッグデータ変換のために設計されており、通常のデータウェアハウスの標準的なロード処理にはオーバースペックなのです。
データ変換が本来行われるべき場所
- データを保持しているデータベースエンジン内部: Fabric、Synapse、Azure SQL、SQL Server は、いずれも強力なセットベースのデータベースエンジンです。差分ロードは、これらのエンジンが最も得意とする処理です。
- 全件再処理ではなく差分(デルタ)処理: 自動生成された Vault ロードは、すでに履歴保持されているデータと照合し、変更があったレコードのみを最小限の処理で反映します。
- プラットフォームごとに一度だけ自動生成: 個々の開発者がフローごとに手探りでチューニングするのではなく、ターゲットエンジンに合わせて極限まで最適化されたセットベースの SQL が一貫して自動生成されます。
Datavault Builder による変革
Datavault Builder は、Hub、Link、Satellite のためのセットベースの差分ロードを自動生成し、Fabric、Synapse、Azure SQL、SQL Server 向けに最適化してコンパイルします。これにより、途中に外部クラスターを介在させることなく、ウェアハウス内部で直接標準的なデータ変換を実行します。
- 標準ロードにクラスターは一切不要: ロード処理は、すでにデータを保持しているエンジン内の SQL 文として直接実行されます。クラスターの起動待ちも、無駄なアイドル費用も発生しません。
- すべてのロード処理が差分処理: 新規および変更された行のみが移動・処理されるため、データ全体の総量ではなく、ソースの変更量に応じた最小限のコンピュートコストしかかかりません。
- 履歴管理はサテライトに記録、再計算は不要: 過去時点の問い合わせ(as-was)には、記録済みの変更差分から直接回答できるため、毎晩過去データ全体を再集計する必要はありません。
- Spark は真に必要なワークロードだけに限定: 極めて巨大なデータセットや非構造化データの処理にのみクラスターを残します。それらは例外的な処理となり、ウェアハウス全体のベースコストを押し上げる要因ではなくなります。
- コンピュートコストの予測が容易: ウェアハウスのキャパシティは事前に計画・予約できる安定したリソースです。実行ごとの予測不能なクラスター稼働時間とは異なります。
今すぐ判断すべきこと
Azure の請求書から Mapping Data Flow の項目を取り出し、1 回の実行あたりの処理行数で各フローを並び替えてみてください。クラスターの起動コストが実際の処理価値を上回っているすべてのフローは、クラスターではなくネイティブ SQL として自動生成すべき対象です。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
データパイプラインを自社で完全に掌握する 3 つのステップ
-
処理行数ごとに Data Flow を洗い出す
大半のフローは小規模です。小さなテーブルごとにクラスターを立ち上げることが、コスト肥大化の最大の原因です。
-
データロードをネイティブ SQL として自動生成する
Datavault Builder は、Fabric、Synapse、Azure SQL、SQL Server 向けに最適化されたセットベースの差分ロードを自動コンパイルし、データが存在するエンジン内で直接実行します。
-
Spark は本来 Spark が必要な処理だけに限定する
真に大規模なデータや非構造化データの変換処理のみをクラスター上に残します。通常のウェアハウスのロード処理にクラスターは不要です。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得







専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。

Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
Azure Data Factory の課題:UI パイプラインと Spark 変換の隠れたコスト
Azure Data Factory は Azure 内部のデータ転送層としては優れていますが、データウェアハウスを保持する場所としては不向きです。モデリングや変換基盤として使ってしまうと、誰も解読できないキャンバス、ARM テンプレートのデプロイ失敗、1 行の SQL で済む処理のための Spark クラスターなど、多くの摩擦が生じます。そして何より、それらのパイプラインはすべて Azure 専用に縛られています。
-
Azure Data Factory のリリースが ARM テンプレートの修正作業に追われていませんか?
ビジュアルエディタの裏側で、Azure Data Factory の実体は JSON です。パイプライン、データセット、リンクサービス、そしてそれらをデプロイする ARM テンプレートで構成されています。開発環境から本番環境へリリースする際、パラメータファイルやグローバルパラメータの調整に追われ、わずか 1 つのデータ型の不一致でデプロイが中断します。リリースはロールバック機能も含めてモデルから自動生成されるべきです。
-
Azure Data Factory のキャンバスが開発チームの手に負えなくなっていませんか?
ドラッグ&ドロップのパイプラインは構築は迅速ですが、変更には多大な時間がかかります。数十のアクティビティを超えると、キャンバス自体がドキュメントと化し、配線作業がロジックを覆い隠します。解決策はキャンバスを整理することではなく、パイプラインを自動生成するモデルを導入することです。
よくあるご質問
- クラスターをウォーム状態に保つことで待ち時間は解消されますが、待機中のクラスターに対しても課金が発生します。つまり、コストが起動時間からアイドル時間へシフトしたに過ぎません。根本的な疑問は、「なぜ標準的なウェアハウスのデータロードにそもそもクラスターが必要なのか」という点にあります。
- いいえ、異なります。Azure Integration Runtime が管理する Spark クラスター上で動作し、vCore 時間単位で課金されます。Azure Databricks は独自の料金体系を持つ独立した別サービスです。
- はい、可能です。ストアドプロシージャやスクリプトアクティビティを使用すればまさにそれが実現でき、コスト面でも公平な比較対象となります。問題は、標準的なウェアハウスのロードに Mapping Data Flow を使用してしまう点、そしてアクティビティから呼び出すプロシージャをテーブルごとに手作業で作成・保守しなければならない点です。自動生成によるデータロードを導入すれば、手書きのプロシージャを一切保守することなく、データベースエンジン内でのネイティブ実行の恩恵を享受できます。
- リレーショナルデータのセットベース処理においては、ほぼ例外なく安価です。データベースエンジンにはすでにデータが格納されており、まさにそのようなクエリ処理に最適化された料金体系になっているからです。Spark が真価を発揮するのは、極めて大規模なデータや非リレーショナルな変換処理に限られ、それらはデータウェアハウスの日常的なロード処理の中ではごく一部に過ぎません。