dbt 導入後もデータ取り込み(インジェスチョン)に悩まされていませんか?
dbt は意図してデータ変換(Transform)に特化したツールとして設計されています。生データがすでにウェアハウス内に存在することを前提としているため、データのランディングには別の製品と別個の請求書が必要になります。Fivetran と dbt Labs が合併した現在でもこの構造は変わりません。取り込みとモデリングを 1 箇所で完結させるプラットフォームなら、二重契約なしにこのギャップを埋めることができます。
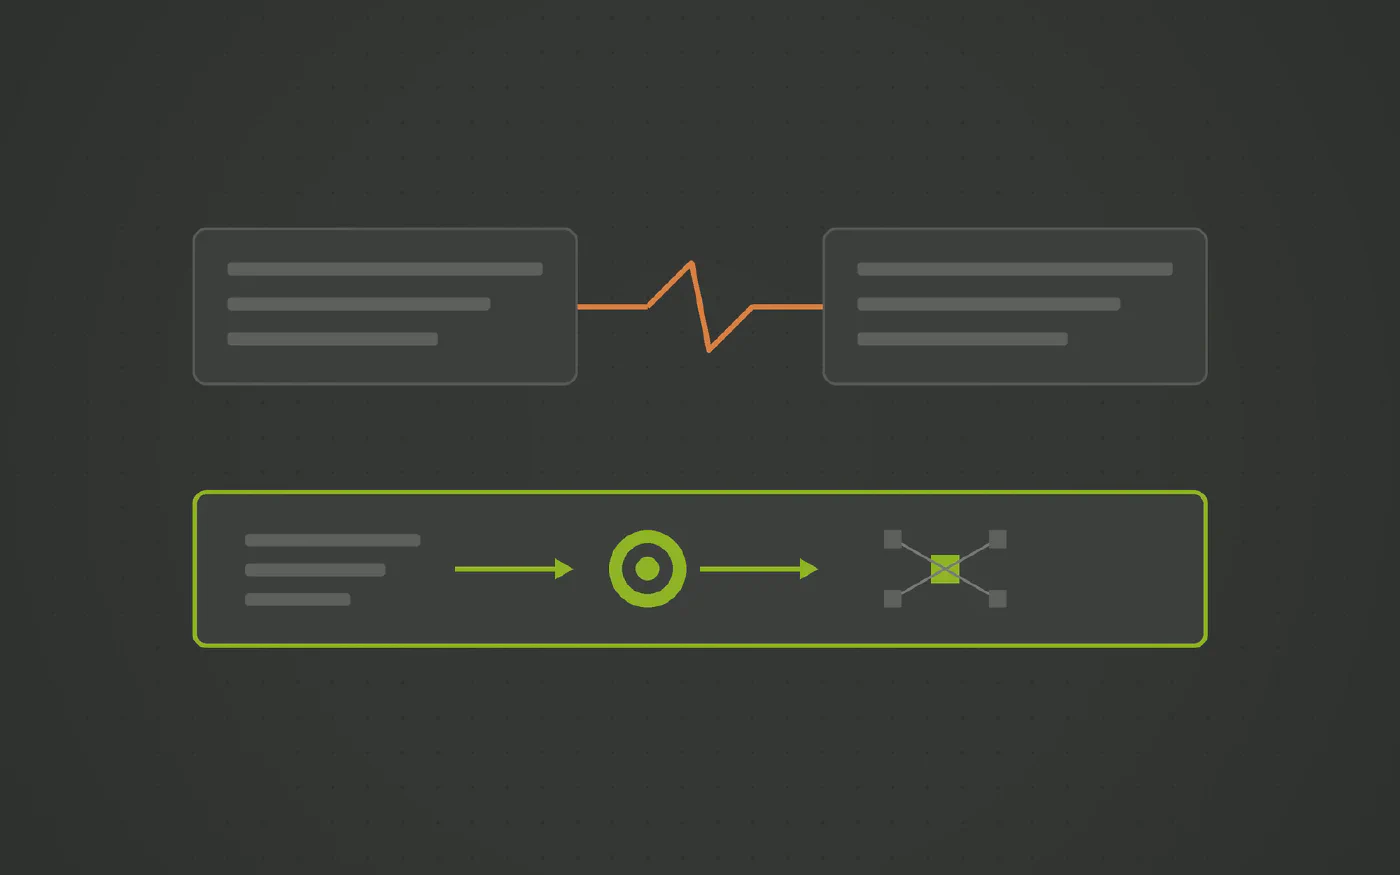
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション









このような課題はありませんか?
- 最初の dbt モデルを実行する前に、別の製品を使ってデータをランディングさせる必要があり、その製品には独自の料金体系、スキーマ構造、障害要因が存在する。
- データパイプラインが 2 つの独立したシステムに分断されており、インシデントが発生するたびにどちらのシステムに原因があるかを突き止めることから始めなければならない。
- dbt のソーステーブルの下流でランディングスキーマが勝手に変更され、翌朝の定期実行が失敗して初めてそれに気づく。
- dbt 内のステージング層の大部分が、取り込みツールが勝手に決定したデータ形状を手作業で元に戻すためだけに存在している。
dbt(現在は Fivetran と同一企業)は、明確に「データ変換(Transform)」に特化したツールです。外部ソースからのデータ抽出(Extract)やロード(Load)は行いません。これは設計思想としては明快ですが、結果としてすべてのデータチームは、最初の dbt モデルを実行する前に、別のデータ取り込み製品を選定・調達・設定し、追加の利用料を支払わなければならないという構造的な課題を抱えることになります。
このギャップが見た目以上に高コストな理由
- 2 つの製品、2 つの請求書: 取り込みツールは行数(MAR)やコネクタ数で課金され、変換ツールはアカウント数や実行量で課金されます。互いの課金体系や処理負荷を考慮しないまま別々にコストが膨らみます。
- 2 重のスキーマ構造: 取り込みツールは自身が扱いやすい独自の形状でデータをランディングさせます。その結果、dbt のステージング層は、その取り込みツール特有のスキーマ構造を自社プロジェクトで使える形へ加工し直すためだけに最初の何層ものモデルを費やすことになります。
- システム境界でのインシデント頻発: 取り込み側でのスキーマ変更が、翌朝の dbt 実行エラーとして突然発覚します。「取り込み側の問題か、変換側の問題か」という責任のなすり合いが、問題解決の初動を遅らせます。
- 企業の合併はアーキテクチャの分断を即座には解決しない: 2026 年 6 月 1 日に Fivetran と dbt Labs は 1 つの会社になりましたが、依然として別々の製品であり別々の料金体系です。ランディングされた生データがそのまま分析用モデルにならないという本質的な課題はそのまま残っています。
データ取り込みが本来属するべき場所
- データモデルのすぐ隣: ビジネスキーや履歴管理のルールを熟知しているツールこそが、モデルが要求する最適な形式でソースデータをロードするのに最も適しています。
- 行単位ではなく、ウェアハウス全体のインフラとして課金: プラットフォームを介した直接ロードは自社の既存コンピュート上で動作するため、取り込み行数に応じた法外な追加課金は発生しません。
- 単一の責任範囲: システム間の受け渡しポイントが存在しなければ、どちら側がパイプラインを破壊したのかという不毛な議論自体が消滅します。
Datavault Builder による変革
Datavault Builder は、同一プラットフォーム上でデータの取り込みとモデリングを一体化して実行します。データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ、差分、CDC ロード、さらには Kafka などのストリーム(Trino 経由のマイクロバッチ)を直接取り込み、Hub、Link、Satellite へマッピングします。
- ランディングのための別製品が不要: ウェアハウスを自動生成する単一プラットフォームにデータソースを直接接続。契約もツールも 1 つにまとまり、障害時の調査箇所も 1 箇所で完結します。
- 余計な中間スキーマの排除: ランディングテーブルは到着と同時に直接モデルへマッピングされます。ステージング層で取り込みツールの独自仕様を元に戻すような不毛な作業は一切発生しません。
- スキーマ変更への堅牢な対応: 新しいカラムの追加はマッピング定義の更新だけで対応でき、翌朝のパイプライン障害を引き起こしません。
- 同一ツール内で配信層までスムーズに構築: セマンティック層上でのドラッグ&ドロップにより、バージョン管理されたビジネスルールを持つマートを直感的に作成可能。dbt での運用を継続したい場合も、同一モデルから dbt モデルを自動生成できます。
- 既存コネクタとの共存も可能: 小規模なロングテール SaaS ソースは既存のマネージドコネクタをそのまま使い続け、基幹系や大容量ソースをプラットフォームで取り込むといった柔軟な運用が可能です。
今すぐ判断すべきこと
取り込みツールの出力スキーマと、それを dbt で修正・加工しているステージングモデルを、別々の担当者が管理しているデータソースをリストアップしてみてください。それらのソースこそが、プラットフォームを通じて直接ランディング・統合すべき最優先の対象です。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
データパイプラインを自社で完全に掌握する 3 つのステップ
-
単一プラットフォームで直接ランディングする
Datavault Builder は、データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ、差分、CDC ロードを直接取り込みます。
-
取り込んだデータ上で直接モデリングを行う
同一ツール内でソースデータを Hub、Link、Satellite に直接マッピング。システムの受け渡しや別スキーマのすり合わせ作業は一切発生しません。
-
同一モデルから配信層を構築する
ドラッグ&ドロップでデータマートやデータプロダクトを構築可能。既存の運用に合わせて dbt モデルを自動生成することもできます。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得







専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。

Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
dbt のトレードオフ:モデル乱立、隠れた TCO、そして自動モデリングへの転換
dbt は SQL にソフトウェアエンジニアリングの手法をもたらし、多くのチームに支持されました。しかしその代償として、コード量、運用コスト、コンピュート費用が肥大化し続ける変換レイヤーを抱え込むことになり、取り込みツールも依然として別製品のままです。自動生成される Data Vault は、そのレイヤー全体をコードベースから取り除きます。dbt を完全に置き換えることも、共存させることも可能です。
-
dbt の実行処理がウェアハウスのコンピュート費用を密かに押し上げていませんか?
dbt はすべての処理をウェアハウス内で実行するため、差分更新で済む場所で全件リフレッシュを行ったり、毎晩テーブルを全件再構築したりしていてもエラーにはならず、消費クレジットとして静かに跳ね上がります。dbt において増分更新ロジックは手書きのオプションに過ぎません。一方、自動生成される Data Vault では、すべてのロード処理が最初から差分処理として構築されます。
-
dbt プロジェクトで誰も全容を説明できないモデルが乱立していませんか?
ref() 関数のおかげで、1 行書くだけで誰でも簡単に新しいモデルを作成できます。その結果、ガバナンスの効かない何百もの SQL ファイルがプロジェクト内に蓄積されます。上流のビジネスキーを 1 つ変更すると、その影響を受けるモデルを探し回る羽目になります。解決策はテストを増やすことではなく、構造を手作業で蓄積する代わりにモデルから自動生成することです。
よくあるご質問
- 2026 年 6 月 1 日に合併が完了しましたが、Fivetran と dbt Cloud は現在も別々の価格体系を持つ独立した製品のままです。また、Fivetran がランディングするスキーマ構造は、dbt が必要とするモデル構造とは依然として一致していません。両社は今後より密接な統合を進めると表明していますが、現時点では「2 社のツール間のギャップ」から「1 つのベンダー内の 2 製品間のギャップ」に変わったに過ぎません。
- JDBC 経由のデータベース、各種ファイル、REST API、Trino コネクタ経由の NoSQL ストア、gRPC コネクタ経由の Python ソースからのバッチ、差分、CDC ロードに対応しています。Kafka などのストリームデータは Trino を介してマイクロバッチとして取り込まれます。CDC 機能は Enterprise プランに含まれています。
- いいえ、その必要はありません。安価で使い勝手の良い SaaS ソース群はそのまま既存ツールに任せ、大量データや複雑なソースを Datavault Builder で直接取り込むといった柔軟なハイブリッド構成が可能です。Data Vault 層はその背後ですべてを統合します。