dbt プロジェクトで誰も全容を説明できないモデルが乱立していませんか?
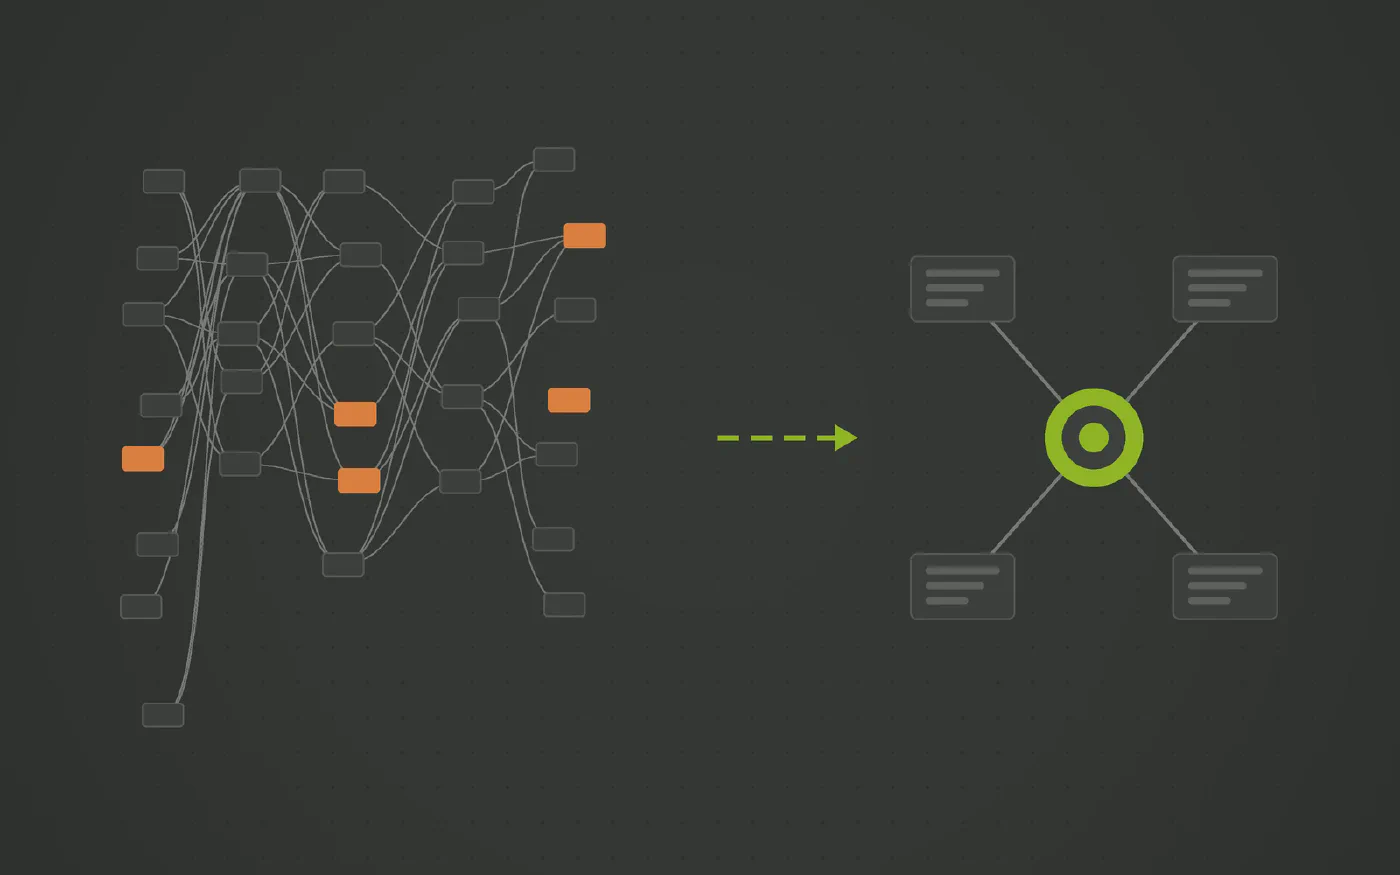
ref() 関数のおかげで、1 行書くだけで誰でも簡単に新しいモデルを作成できます。その結果、ガバナンスの効かない何百もの SQL ファイルがプロジェクト内に蓄積されます。上流のビジネスキーを 1 つ変更すると、その影響を受けるモデルを探し回る羽目になります。解決策はテストを増やすことではなく、構造を手作業で蓄積する代わりにモデルから自動生成することです。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション









このような課題はありませんか?
- DAG に何百ものモデルが連なっており、その半分以上がなぜ存在しているのかを説明できるメンバーがほとんどいない。
- 上流のビジネスキーを変更した結果、依存していることすら忘れ去られていた 3 階層下流のモデルが突然エラーを起こす。
- 既存のモデルを正しく再利用するよりもコピー&ペーストする方が早かったため、少しずつ仕様の異なるステージングロジックがプロジェクト内に氾濫している。
- リファクタリングが四半期ごとの計画に組み込まれるものの、実際に完了した四半期は一度もない。
dbt(現在は Fivetran と同一企業)は、データモデルの作成を驚くほど手軽にしました。select * from {{ ref('...') }} と書くだけで、あっという間に新しいノードが追加されます。これは優れた機能ですが、2〜3 年運用を続けるうちに、誰も頭の中で全体像を把握できない何百ものモデルの山が築き上げられます。コードを作成する摩擦がゼロになると、コードの無制限な蓄積がデフォルトの結果になってしまうのです。
プロジェクトが乱立・肥大化する理由
- 既存コードの変更よりもフォーク(複製)の方が手軽: dbt には標準パターンのためのマクロやパッケージが存在しますが、どの開発者でも自由に編集できます。共有マクロを適切に修正するには広範なリグレッションテストやマイグレーションが必要です。その結果、少し要件が合わないだけで別の似たようなモデルがコピーして作成されてしまいます。
- 「構造」と「ロジック」が同じファイルに混在: ソースをステージングするだけのモデル、履歴管理を行うモデル、粗利を計算するモデルが、DAG 上では全く同じ SQL ファイルとして並んでしまいます。
- 依存関係は「宣言」されただけで「設計」されていない:
ref()は「あるモデルが別のモデルを参照している」という事実を記録するだけであり、なぜ参照しているのか、上流のキーが変更されたら何が壊れるのかまでは保証してくれません。 - ガバナンスが常に後手に回る: 命名規則、フォルダ構成、自動テストなどのルールが整備される頃には、すでにプロジェクトは巨大化しており、収拾がつかなくなっています。
これはツールの欠陥ではありません。SQL をモジュール化するフレームワークを与えられれば、エンジニアが大量のモジュール化された SQL を書き上げるのは必然だからです。
構造コードが本来属するべき場所
- 大半のモデルは単なる「構造」である: ステージング、重複排除、キー生成、履歴トラッキングは、カラム名が異なるだけでソースごとに全く同じパターンです。
- 構造コードは蓄積するのではなく、自動生成すべき: ビジネスキー、リレーションシップ、属性を 1 度だけ宣言し、プロジェクトごとに書き換えられない統一された標準パターンからロード用コードを自動導出します。
- ロジックこそが人間が手書きすべき価値ある領域: ビジネスルール、指標の計算式、データマートの形状定義こそが真にレビューに値する部分であり、それらはプロジェクト全体のごく一部に収まるべきです。
Datavault Builder による変革
Datavault Builder はデータ構造をビジュアルなモデルとして保持し、Hub、Link、Satellite、およびそのロード処理をモデルから完全自動生成します。これにより、プロジェクトの大半を占めていた定型コードはファイルとして管理する必要がなくなります。
- 1 つの概念に 1 つの定義: 5 つのデータソースを持つ顧客 Hub は、1 つの Hub と 5 つのマッピングとしてモデルに定義されます。フォルダ内に 15 個の個別モデルを散乱させる必要はありません。
- 依存関係はモデルから自動導出: ロード順序とリネージはモデルから自動計算されるため、上流のキー変更の影響はデプロイ後に障害として現れるのではなく、事前に画面上で可視化されます。
- メタデータがレイヤー間をシームレスに貫通: データ型、キー、説明文は 1 度定義すればステージングからマートまで自動伝播し、各モデルファイルで二重三重に定義する必要はありません。
- リファクタリングは単なるモデル編集: マッピングを変更して再生成を実行するだけで、依存するすべての構造が一貫性を保ったまま再構築されます。
- モデル自体が生きたドキュメント: データリネージ、定義、履歴管理ルールが 1 箇所で視認可能であり、ドキュメントの別途ビルドは不要です。
- ビジネスルールをモデル内でバージョン管理: セマンティック層上でのドラッグ&ドロップにより配信層を直感的に構築でき、ビジネスルールは履歴とともに安全に管理されます。
- dbt との共存も自動生成で実現: dbt による運用を継続したい場合でも、モデルから dbt モデルを直接自動生成・再生成できるため、手作業で何百ものファイルを修正し続ける悪夢から解放されます。
今すぐ判断すべきこと
自社の dbt プロジェクトのモデルを点検し、各モデルの役割(ステージング、キー処理、履歴保持、ビジネス計算)を分類してみてください。もし最初の 3 つが大部分を占めているなら、それらは本来すべてモデルから自動生成できる構造コードです。
貴社のデータソースで実際の動作をご確認ください
無料デモをお申し込みいただき、費用や保守工数が最もかかっているコネクタをお持ち寄りください。
データパイプラインを自社で完全に掌握する 3 つのステップ
-
「構造」と「ロジック」を明確に分離する
ステージング、ビジネスキー、変更履歴は「構造」です。ビジネスルールや指標は「ロジック」です。乱立しているモデルの大半は単なる構造コードです。
-
構造コードはモデルから自動生成する
Hub、Link、Satellite、およびそのロード処理は Datavault Builder のモデルから生成されます。ビジネス概念ごとに 1 つの定義を持つだけで済みます。
-
モデルから直接ビジネス層へ配信する
ドラッグ&ドロップでデータマートやデータプロダクトを構築し、ビジネスルールはプラットフォーム内でバージョン管理します。必要に応じて dbt モデルを自動生成することも可能です。
Datavault Builder がデータ取り込みの摩擦を解消する仕組み
-
取り込み機能を標準で統合
データベース、ファイル、REST API、NoSQL、Python ソースからのバッチ・差分・CDC ロードに対応し、Kafka などのストリームもマイクロバッチとして取り込み可能。ウェアハウス生成と同一の単一プラットフォームで完結し、追加のツール費用は不要です。
-
ベンダー仕様ではなく自社設計のスキーマ
ソーステーブルは自社で設計した Data Vault 2.0 モデルにマッピングされます。カラム追加やテーブル名変更が発生しても、マッピングを調整するだけで対応でき、ロード後のスクリプト修正作業は不要です。
-
差分(デルタ)のみを転送・処理
Hub、Link、Satellite は変更分のみを効率的にロードします。フルリロードデータはステージングに留まり、下流で毎晩再処理されるような無駄な負荷を発生させません。
-
設計段階から変更履歴を確実に保持
すべての変更履歴が到着順に記録されるため、ソース側でレコードが上書きされても過去時点の正確な状態(as-was)を遡って集計・レポーティングできます。
-
手作業でのコーディングは一切不要
ロード処理、履歴管理、データリネージはモデルからリアルタイムで自動生成され、Snowflake、Databricks、BigQuery、SQL Server、Fabric、Oracle、PostgreSQL 上でネイティブに実行されます。
-
1 つのプラットフォームで最大 9 つのツールを集約
モデリング、ETL、CI/CD、ドキュメント生成、リネージ管理を 1 つの環境に統合。要件定義から本番環境へのデプロイまでわずか 14.7 分という迅速なデリバリーを実現します。
BARC「The Data Fabric Survey 26」で高評価を獲得







専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の技術スタックに適合するか率直にお答えします。

Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
dbt のトレードオフ:モデル乱立、隠れた TCO、そして自動モデリングへの転換
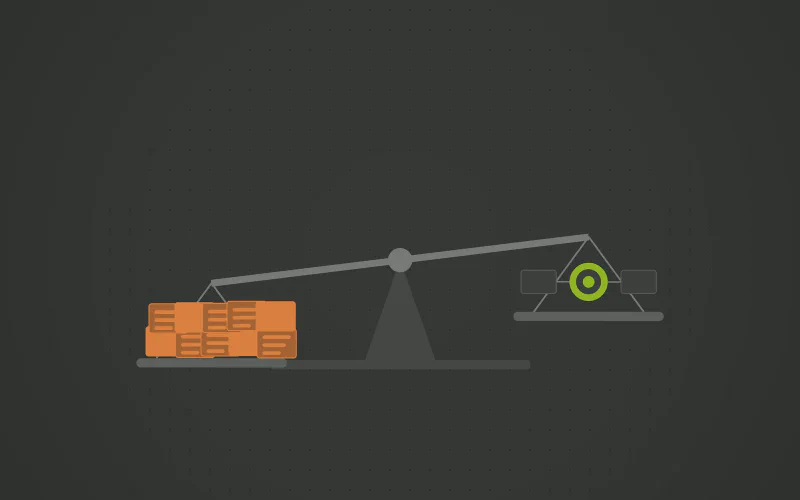
dbt は SQL にソフトウェアエンジニアリングの手法をもたらし、多くのチームに支持されました。しかしその代償として、コード量、運用コスト、コンピュート費用が肥大化し続ける変換レイヤーを抱え込むことになり、取り込みツールも依然として別製品のままです。自動生成される Data Vault は、そのレイヤー全体をコードベースから取り除きます。dbt を完全に置き換えることも、共存させることも可能です。
-
dbt 導入後もデータ取り込み(インジェスチョン)に悩まされていませんか?
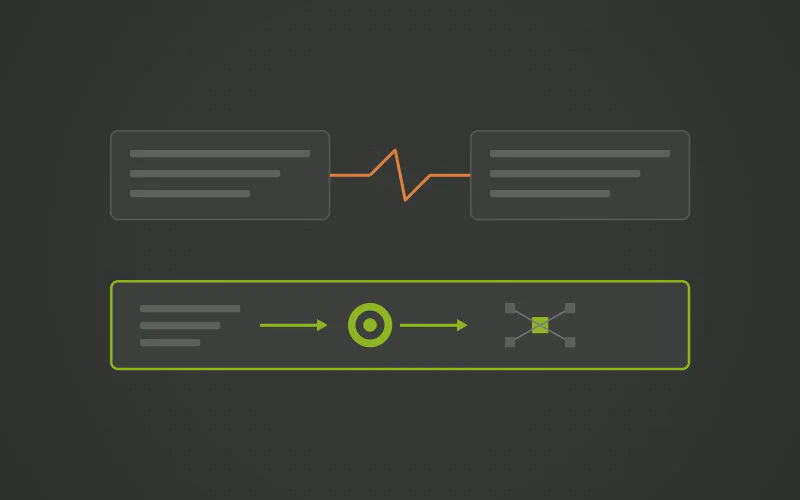
dbt は意図してデータ変換(Transform)に特化したツールとして設計されています。生データがすでにウェアハウス内に存在することを前提としているため、データのランディングには別の製品と別個の請求書が必要になります。Fivetran と dbt Labs が合併した現在でもこの構造は変わりません。取り込みとモデリングを 1 箇所で完結させるプラットフォームなら、二重契約なしにこのギャップを埋めることができます。
-
dbt の実行処理がウェアハウスのコンピュート費用を密かに押し上げていませんか?
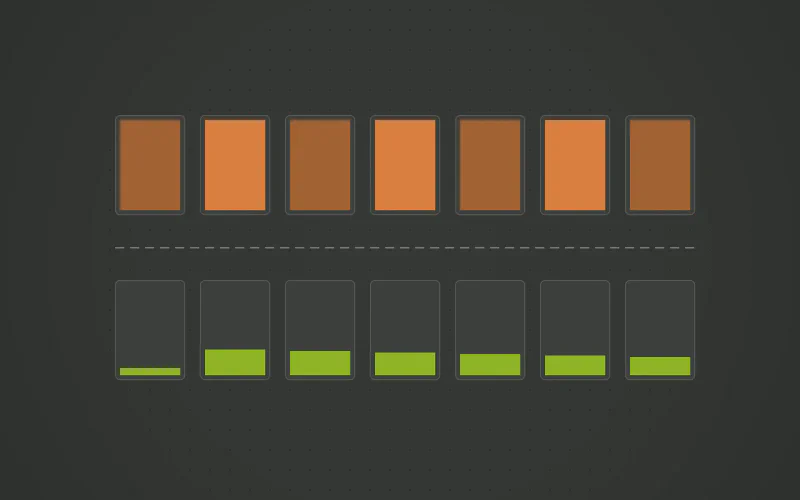
dbt はすべての処理をウェアハウス内で実行するため、差分更新で済む場所で全件リフレッシュを行ったり、毎晩テーブルを全件再構築したりしていてもエラーにはならず、消費クレジットとして静かに跳ね上がります。dbt において増分更新ロジックは手書きのオプションに過ぎません。一方、自動生成される Data Vault では、すべてのロード処理が最初から差分処理として構築されます。
よくあるご質問
- AutomateDV はモデルごとに設定したマクロから Hub、Link、Satellite の SQL を生成してくれるため、完全な手書きコードに比べれば大きな進歩です。しかし、ステージング層の構築、各マクロ呼び出しのためのメタデータ管理、実行順序の制御、ソース変更時の履歴ハンドリングは依然として自前で記述・保守しなければなりません。Datavault Builder では、これらすべてが 1 つのビジュアルモデルから自動導出され、モデル変更に即座に追従します。また、既存プロジェクトからの直接移行パスも用意されています。Migration Vault(Hub、Link、Satellite、ソース、キーのデータモデル)に既存の AutomateDV メタデータをマッピングすれば、Datavault Builder がデプロイパッケージを直接自動生成します。
- いいえ、全く異なります。モデル内では、変換ステップごとの SQL ファイルではなく、ビジネス概念とソースマッピングごとに 1 つのエントリが存在するだけです。たとえば 5 つのソースを持つ顧客 Hub は、1 つの Hub と 5 つのマッピングとして表現され、15 個ものバラバラな SQL モデルに膨れ上がることはありません。
- はい、2 つの形で共存できます。第 1 に、自動生成される Vault やマートは標準的なテーブルやビューであるため、既存の dbt モデルからそのまま読み込むことができます。第 2 に、運用のワークフローを dbt に集約したい場合、Datavault Builder が自らのモデルから dbt モデルを自動生成します。変更が必要な際もモデルを修正して再生成するだけで済むため、モデルの乱立が再発することはありません。