Tableau ダッシュボードのフィルターを切り替えるたびに待たされていませんか?
フィルターを 1 つクリックするたびに「クエリを実行中...」が 20 秒間表示される。Tableau の描画エンジンが遅いのではありません。データベース側に、即答できない構造の質問が投げかけられていることが原因です。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション









このような課題はありませんか?
- フィルターを 1 つ切り替えるたびに、画面に「クエリを実行中...」のスピナーが 20 秒以上表示される。
- パフォーマンスの記録を採取すると、所要時間の大半が「クエリの実行」に費やされており、描画処理にはほとんど時間がかかっていない。
- データ量が 1 四半期分なら快適に動くが、3 年分になると使い物にならなくなる。
- ユーザーが重い処理をトリガーしないよう、ダッシュボード上のフィルターを非表示にし始めている。
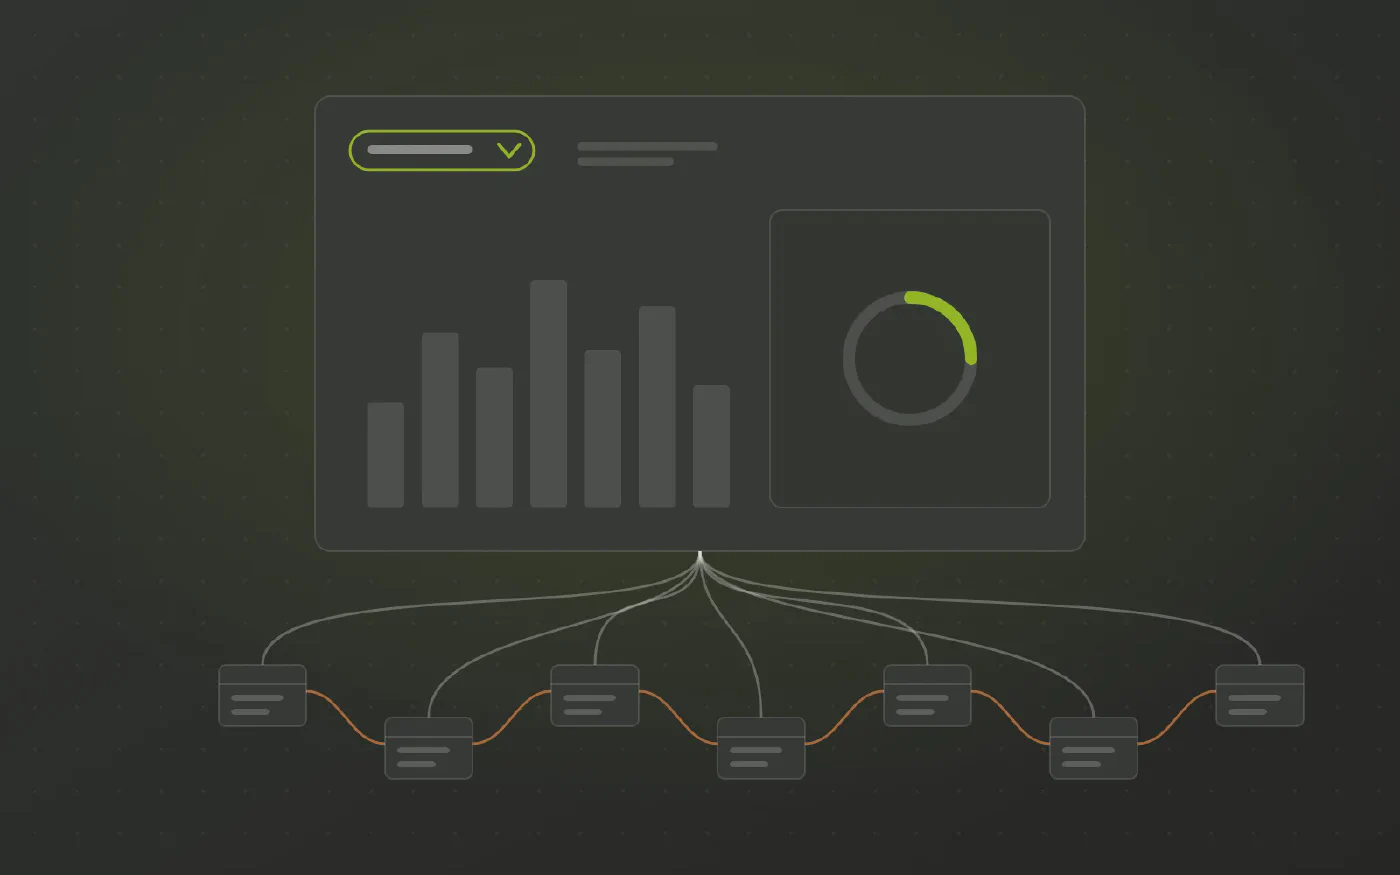
ボトルネックになっているのは Tableau ではありません。VizQL はユーザーのあらゆる操作を SQL クエリに変換します。その応答にかかる時間は、クエリ先のテーブルの構造によって完全に左右されます。
VizQL が裏で要求されていること
- スタースキーマに対して実行される場合: 1 つのファクトテーブルと、明確な主キーで結合された数個のディメンションテーブル。ミリ秒単位で結果が返ってきます。
- 第 3 正規形(3NF)や生テーブルに対して実行される場合: 10 個以上のテーブルにまたがる複雑な結合が発生し、マークごと、フィルターごと、ユーザーごとに毎回ゼロから SQL が再構築されます。
- インデックスが効かない: 基幹系のテーブルはトランザクション用にインデックスが貼られており、アナリストが集計に使うグループ化列には最適化されていません。
- ワークシート単位で掛け算される: ダッシュボード上の各ワークシートがそれぞれ独立してクエリを発行するため、負荷が倍増します。
なぜその負担がアナリストに押し付けられるのか
- 与えられたデータソースは「たまたま社内に存在した運用テーブル」であり、分析用途に設計されたものではありませんでした。
- カスタム SQL やデータブレンドを駆使して何とか繋ぎ止めてきましたが、それによって発行されるクエリはさらに重くなっています。
- ワークブック側の計算式やレイアウトをチューニングすることはできても、アナリスト権限でソース側のモデリングを変更することはできません。
本来その処理が行われるべき場所
- 生テーブルを分析可能な構造に結合・整理するのはウェアハウスの責務: VizQL 内でそれをやらせると、フィルターを変更するたびにその重い結合処理が繰り返されます。
- 1 箇所の中央基盤に集約すべき: データウェアハウスやデータハブ側で 1 度だけスタースキーマを構築し、すべてのワークブックが最適化されたテーブルを参照すべきです。
- 「DWH の改修は高額で時間がかかる」と思われるかもしれませんが: その見積もりは手作業でパイプラインを構築することを前提としています。専用の自動化プラットフォームを活用すれば、モデルからパイプラインが自動生成されるため、必要なコストと期間は劇的に圧縮されます。
完成したモデルが届いたときに変わること
Datavault Builder は、Snowflake、Databricks、BigQuery、Synapse、SQL Server、Oracle、Exasol、PostgreSQL 上で、分析アクセスに最適化されたファクトおよびディメンションをネイティブに自動生成します。
- 1 つのファクトテーブルと適合ディメンション: VizQL が発行する SQL は構造上非常に短くシンプルになります。
- 明示的な単一キー結合: 複数列の文字列マッチングではなく、高速な単一カラムキーで結合されます。
- テーブルごとの単一の粒度: スキャン行数を不必要に膨らませる重複行が原理的に排除されます。
- ライブ接続が実用的に: 抽出(Extract)への逃げ道を探す必要がなくなり、必要に応じてライブ接続を快適に利用できます。
- フィルターが瞬時に反応するようになり、隠していたフィルターを再びダッシュボードに戻すことができます。
上流チームに何を要求すべきか
「フィルターをクリックするたびに VizQL が複数の正規化テーブルを複雑に結合しており、データ量の増加に伴ってクエリ時間が深刻化しています。運用テーブルを直接叩くのではなく、このダッシュボード専用のスタースキーマをウェアハウス側で提供してもらえませんか?」
このように具体的なメカニズムを指摘することで、ボトルネックの根本原因が存在するレイヤーでの改修を促すことができます。
実際のデータで動作をご確認ください
無料デモをお申し込みいただき、最も課題を抱えているレポートをお持ち寄りください。
数値の整合性を保つための 3 つのステップ
-
既存のロジックを抽出
現在レポート内に点在している計算式、結合、フィルターを整理・収集します。
-
1 か所に集約・一元化
ロジックをデータウェアハウスモデルへ一度集約することで、すべてのレポートが同一の定義を参照します。
-
整合性のある正確な数値を実現
すべてのレポートで整合した数値が表示され、「この数値の出所はどこか」という疑問に明確に答えられるようになります。
Datavault Builder が完成したモデルをレポートに提供する仕組み
-
完成したモデルが即座に利用可能
Datavault Builder は Vault やスタースキーマを自動生成し、SQL Server、Azure SQL、Synapse、Fabric、Snowflake、Databricks、BigQuery など既存のデータベース上でネイティブに実行します。
-
レポート側の集計・変換作業を解消
マージ、パース、ファジーマッチなどの手間がレポート側から完全に不要になります。
-
ソースデータを統合した状態で提供
ERP、CRM、EC サイトなどの顧客データを整合性のあるディメンションに統合。結合処理はデータウェアハウス内で一度だけ行われ、各レポートで毎回繰り返す必要がなくなります。
-
いつでも過去時点のデータを遡及クエリ可能
すべての変更履歴が到着順にそのまま保持されるため、ソース側でレコードが上書き更新された場合でも、当時の状態(as-was)と現在の状態(as-is)の双方を正確にレポーティングできます。
-
すべての数値に明確なリネージを保持
ビジネスロジックにデータリネージが付与されるため、「この数値がどこから算出されたのか」をいつでも可視化できます。
-
上流でデータ変更を適切に処理
緩やかに変化するディメンション(SCD)は、近似処理ではなく、上流の Vault サテライトとして正確に管理されます。
BARC「The Data Fabric Survey 26」で高評価を獲得







専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の環境や要件に適合するか率直にお答えします。

Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
Tableau Server 内で同じ指標の異なるバージョンが乱立していませんか?
公開された各 .tdsx ファイルは、作成された時点ではどれも合理的な判断によるものでした。しかし結果として、同じ指標に対して社内に何百通りもの独自定義が存在し、どれが正しいのか誰も判断できない状態に陥っています。
-
Tableau の LOD 表現が複雑すぎて誰も手を付けられなくなっていませんか?
FIXED、INCLUDE、EXCLUDE は、本来異なる粒度(Grain)が混在する集計を行うための強力な機能です。しかしワークブック内にある LOD 表現の大半は、データウェアハウス側でデータの粒度が揃っておらず、履歴が保持されていない穴埋めとして使われています。
-
Tableau の抽出更新がタイムアウトや遅延を繰り返していませんか?
Tableau の Backgrounder がタイムアウトし、.hyper ファイルが肥大化し続け、ダッシュボードには昨日の古いデータが表示される。抽出が重い真の原因は、上流で集計されていない生のトランザクション行を Tableau 側で抱え込んでいることにあります。