Power BI の DirectQuery レポートがクリックのたびに重くありませんか?
DirectQuery や Direct Lake はリアルタイムな最新データを提供すると謳われています。しかし実際に起きるのは、表示に 30 秒かかるビジュアルと、誰も説明できない高額なクラウドアカウントの請求書です。問題は DirectQuery モード自体ではなく、その下にあるスキーマ構造にあります。
さまざまな業界のデータチームから信頼されるデータウェアハウス自動化ソリューション









このような課題はありませんか?
- スライサーやフィルターを 1 回クリックするたびに大量のクエリが一斉に発行され、ビジュアルの読み込みが極端に遅くなる。
- ダッシュボードを本番公開したその月から、Synapse や Microsoft Fabric のコンピュートコストが急増した。
- Direct Lake が静かに DirectQuery へフォールバックしているが、その理由が誰にも分からない。
- インポートモードに切り替えると高速に動作するため、やむを得ずインポートにしてリアルタイム性を諦めている。
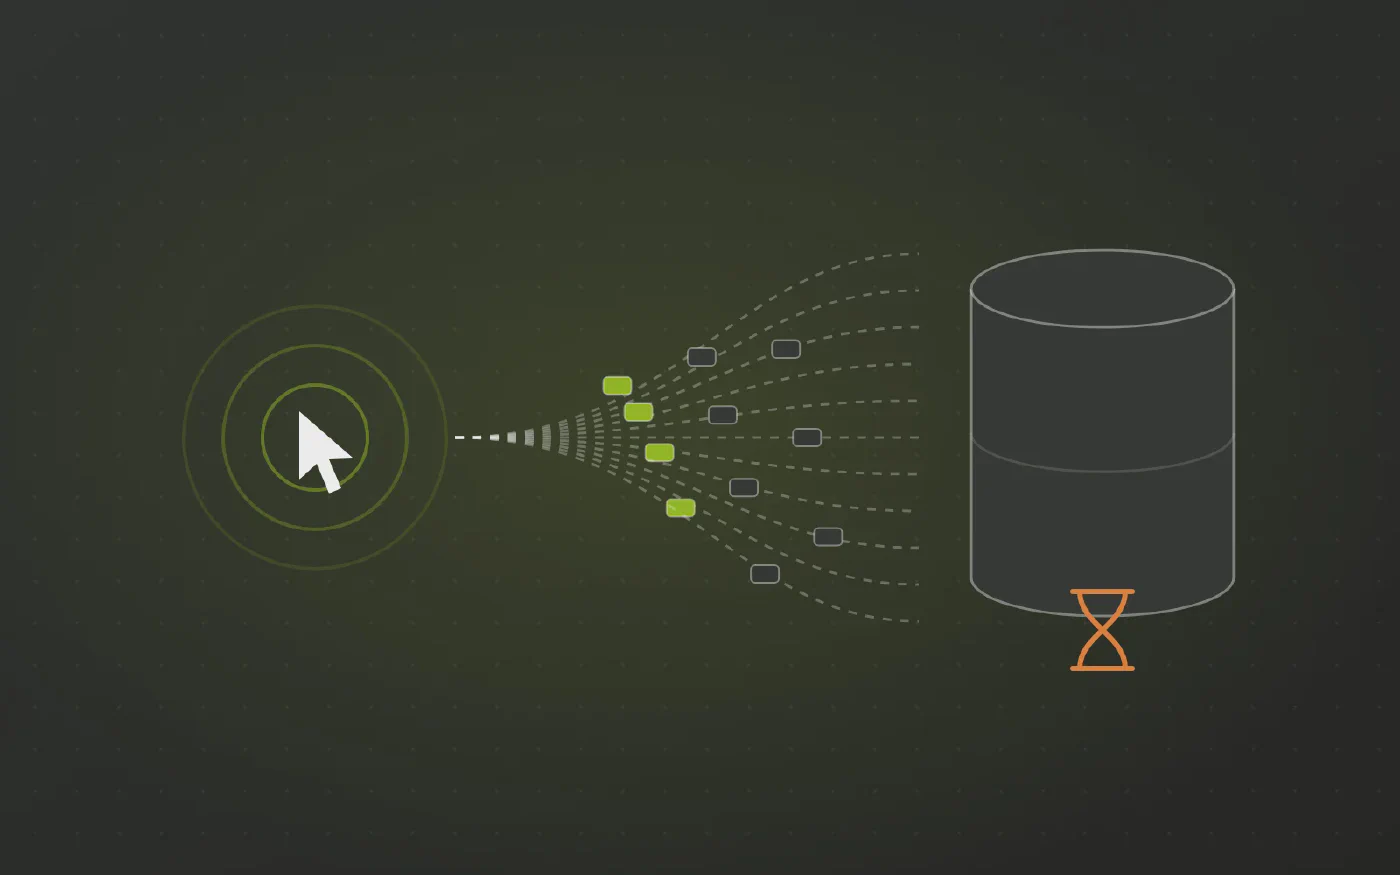
DirectQuery は文字通り、ユーザーのあらゆる操作をデータベースへの即時 SQL クエリに変換します。それが高速に動くかどうかは、裏側にあるデータ構造によって完全に決まります。
DirectQuery が生成するクエリの実態
- スタースキーマに対して実行される場合: 1 つのファクトテーブルと、確定したキーで結合された数個のディメンションテーブル。データベースはミリ秒単位で結果を返します。
- 第 3 正規形(3NF)や生のレイクテーブルに対して実行される場合: 10 個以上のテーブルにまたがる複雑なネスト結合が発生し、ビジュアルごと、クリックごとに毎回ゼロから SQL が組み立てられます。
- プッシュダウンが効かない構造: パーティションや適切なインデックスが存在しないテーブルでは、毎回フルスキャンが走ります。
- 静かなフォールバック: Direct Lake は、ソースデータの形式が要件に満たない場合、何のエラーも出さずに静かに DirectQuery へフォールバックします。このとき予期せぬコンピュートコストが発生します。
これにページ上のビジュアル数、そして同時アクセスするユーザー数を掛け算してみてください。それが膨れ上がった請求書の正体です。
なぜその負担がアナリストに押し付けられるのか
- ウェアハウスが提供しているのは基幹システムの運用テーブルのコピーであり、分析用に最適化されたテーブルではありません。
- インポートモードへの変更は一時しのぎに過ぎず、DirectQuery を選んだ最大の理由である「リアルタイムデータ」を失うことになります。
- ビジュアルの配置や表示件数は調整できても、アナリスト権限では基盤側のパーティション再構成はできません。
本来その処理が行われるべき場所
- 分析用にテーブル構造を整えるのはウェアハウスの責務: DirectQuery はスキーマを最適化できません。クリックのたびに支払っている遅延とコストは、適切なモデリングを怠ったツケです。
- 1 箇所の中央基盤に集約すべき: データウェアハウスやデータハブ側で 1 度だけスタースキーマを整備し、すべてのレポートが高速に参照できるようにすべきです。
- 「DWH の改修は高額で時間がかかる」と思われるかもしれませんが: その見積もりは手作業でパイプラインを構築することを前提としています。専用の自動化プラットフォームを活用すれば、モデルからパイプラインが自動生成されるため、必要なコストと期間は劇的に圧縮されます。
完成したモデルが届いたときに変わること
Datavault Builder は、ターゲットプラットフォーム(Snowflake、Databricks、Fabric、Synapse など)上でネイティブに動作するディメンショナルモデル(実テーブルまたは最適化ビュー)を自動生成します。トランザクション用ではなく、分析クエリのプッシュダウンに最適化された構造です。
- 1 つのファクトと明確なディメンション: 生成される SQL は構造上シンプルで極めて短くなります。
- 最適なパーティションとクラスタリング: ユーザーが実際にフィルターやスライサーで絞り込む列に基づいて最適化されます。
- Direct Lake が確実に維持される: テーブルが最初から Direct Lake の要求する形状で生成されるため、DirectQuery へのフォールバックが防がれます。
- コンピュートコストが激減: 各クリックが生レイヤーではなく軽量で最適化されたモデルをスキャンするため、クラウドコストが大幅に抑制されます。
- リアルタイム性と処理速度のトレードオフが解消されます。
上流チームに何を要求すべきか
「DirectQuery がクリックごとに正規化テーブル群を複雑に結合しているため、ユーザーが増えるほどコンピュートコストが跳ね上がっています。このレポート用に、パーティション分割されたスタースキーマをウェアハウス側で提供してもらえませんか?」
このように具体的に要望を伝えることで、問題の根本原因があるレイヤーに対して正確な改修を依頼できます。
実際のデータで動作をご確認ください
無料デモをお申し込みいただき、最も課題を抱えているレポートをお持ち寄りください。
数値の整合性を保つための 3 つのステップ
-
既存のロジックを抽出
現在レポート内に点在している計算式、結合、フィルターを整理・収集します。
-
1 か所に集約・一元化
ロジックをデータウェアハウスモデルへ一度集約することで、すべてのレポートが同一の定義を参照します。
-
整合性のある正確な数値を実現
すべてのレポートで整合した数値が表示され、「この数値の出所はどこか」という疑問に明確に答えられるようになります。
Datavault Builder が完成したモデルをレポートに提供する仕組み
-
完成したモデルが即座に利用可能
Datavault Builder は Vault やスタースキーマを自動生成し、SQL Server、Azure SQL、Synapse、Fabric、Snowflake、Databricks、BigQuery など既存のデータベース上でネイティブに実行します。
-
レポート側の集計・変換作業を解消
マージ、パース、ファジーマッチなどの手間がレポート側から完全に不要になります。
-
ソースデータを統合した状態で提供
ERP、CRM、EC サイトなどの顧客データを整合性のあるディメンションに統合。結合処理はデータウェアハウス内で一度だけ行われ、各レポートで毎回繰り返す必要がなくなります。
-
いつでも過去時点のデータを遡及クエリ可能
すべての変更履歴が到着順にそのまま保持されるため、ソース側でレコードが上書き更新された場合でも、当時の状態(as-was)と現在の状態(as-is)の双方を正確にレポーティングできます。
-
すべての数値に明確なリネージを保持
ビジネスロジックにデータリネージが付与されるため、「この数値がどこから算出されたのか」をいつでも可視化できます。
-
上流でデータ変更を適切に処理
緩やかに変化するディメンション(SCD)は、近似処理ではなく、上流の Vault サテライトとして正確に管理されます。
導入事例: Porta
BARC「The Data Fabric Survey 26」で高評価を獲得







専門家にご相談ください
弊社のセールスディレクターが 20 分間で、貴社の環境や要件に適合するか率直にお答えします。

Matt Collett
Sales Director
ご都合の良い日時をお選びください:
本シリーズで解説するその他の課題
-
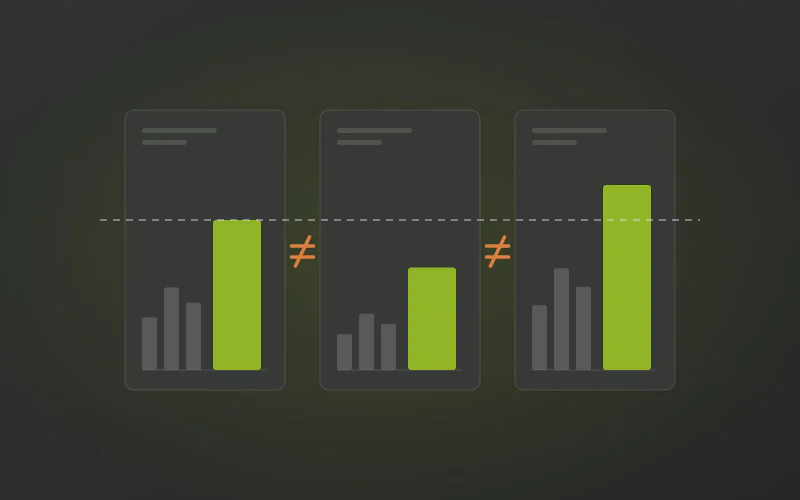
Power BI レポートごとに同じ指標の数値が食い違っていませんか?
財務、営業、運用部門がそれぞれセマンティックモデルを構築し、各モデル内では整合性が取れている。しかし、同じ「売上」でも定義が部門間で合意されたことは一度もない。数値の不一致の原因と、根本的な解決策を解説します。
-
Power BI の DAX メジャーが長すぎて保守不能になっていませんか?
CALCULATE と FILTER が 200 行にも連なる DAX 式は、高度なスキルの証拠ではありません。多くの場合、上流のウェアハウスが必要なサロゲートキー、変更履歴、適切な粒度を提供してくれなかったことの表れです。
-
Power BI の深夜のスケジュール更新が失敗し続けていませんか?
スケジュールされた定期更新がタイムアウトし、Power Query がメモリ不足エラーを起こし、朝ダッシュボードを開いたユーザーからの指摘で初めて障害に気づく。その原因は Power BI 自体ではなく、Power BI に背負わせているデータ処理そのものにあります。