Blog — Data Vault y Automatización del Data Warehouse
Artículos sobre Data Vault 2.0, automatización del data warehouse, Snowflake, Databricks e ingeniería de datos práctica.
-
Soberanía de Datos e IA: DWH Empresarial
¿Cómo mantener el control de sus datos cuando los modelos de IA necesitan acceso a todo? Este webinar muestra cómo combinar gobierno de datos con capacidades modernas de IA.
Leer más → -
Data Vault y el stack Medallion de Databricks
Data Vault y Lakehouse suelen verse como enfoques contradictorios. Este webinar muestra que es justo lo contrario.
Leer más → -
Cómo pienso el valor de negocio en los datos
La mayoría de los proyectos de datos no fracasan por la tecnología. Fracasan porque el valor llega tarde, en la forma equivocada o a un coste demasiado alto.
Leer más → -
Certificación ISO 27001:2022 y SOC 2 Type 2
En el panorama digital de rápida evolución de hoy, la seguridad de los datos no es solo una prioridad — es una necesidad.
Leer más → -
Importar modelos de datos generados por la IA de Flow.BI
Vea cómo migrar metadatos generados por la IA de Flow.BI a Datavault Builder usando el enfoque Migration Vault — mapeo de hubs, links y pipelines ETL automatizadas.
Leer más → -
Integrar y unificar datos
En el modelado Data Vault usamos hubs para integrar datos. Es una de las principales razones por las que elegimos el modelado Data Vault.
Leer más → -
Analítica DWH casi en tiempo real
En el mundo data-driven actual, tarjetas de crédito, redes, sensores IoT y numerosas fuentes de datos proporcionan datos en tiempo real. ¿Cómo procesarlos de forma efectiva?
Leer más → -
SSO en Snowflake Snowpark Container Services
Usar Datavault Builder con los Snowpark Container Services de Snowflake permite a los equipos de datos desplegar y gestionar soluciones de datos sin depender de los equipos de infraestructura.
Leer más → -
Procesamiento de datos bi-temporales
Tanto si trabaja con cuentas de clientes, transacciones financieras o siniestros de seguros, este webinar le prepara para manejar datos bi-temporales.
Leer más → -
DVB en Snowflake Snowpark Container Services
En este vídeo demostramos lo sencillo que es ejecutar Datavault Builder sobre los Snowflake Container Services.
Leer más → -
Check-In y Check-Out GIT directos sobre el modelo
Bienvenido a nuestra breve presentación sobre Datavault Builder 7.1 y su nueva funcionalidad de check-in y check-out GIT para desarrollo ágil.
Leer más → -
El concepto de Migration Vault
Un Migration Vault es un almacén de metadatos especializado diseñado como Data Vault. Facilita la migración de datos de un formato antiguo a uno nuevo, garantizando la compatibilidad.
Leer más → -
Alternativa a Talend Open Studio comparada
Datavault Builder ofrece una gran variedad de funcionalidades y módulos al mismo coste que las herramientas ETL antes gratuitas.
Leer más → -
Automatización del Unified Star Schema
En este vídeo, los espectadores se adentran en el mundo del data warehousing automatizado con el Unified Star Schema, un concepto de Francesco Puppini y Bill Inmon.
Leer más → -
Yale University: revolucionando la gestión de datos — 75 % de ahorro y análisis más rápidos
La automatización de la gestión de datos genera grandes ganancias de productividad: cómo Yale University usó Datavault Builder para reducir un 75 % las horas facturadas, ampliar su equipo de datos y acelerar el time to insight.
Leer más → -
Estudio de caso BI-SPEKTRUM: C&A en Snowflake
BI-SPEKTRUM publicó un artículo en la edición 2023/3 sobre cómo uno de nuestros clientes usa Datavault Builder para integrar sus datos SAP.
Leer más → -
Caso de uso Willibald de la DDVUG
Vea el caso de uso DDVUG Willibald: construir un Data Warehouse completo con 2 fuentes de datos en menos de 3 horas usando Datavault Builder.
Leer más → -
¿Está muerto el modelado de datos?
¿Seguimos necesitando modelos de datos? ¿Cuál es el valor de los modelos? ¿Por qué fracasó el modelado en el pasado? ¿Cómo crear valor modelando?
Leer más → -
Data Vault bi-temporal: Inscription Time
Cómo cargar datos bi-temporales en el Data Vault usando Inscription Time — patrones, trampas y ejemplos prácticos.
Leer más → -
¿Data Vault vs. Data Mesh?
¿Debería seguir haciendo Data Vault si existe Data Mesh? En las últimas semanas y meses he recibido estas preguntas muy interesantes en varias ocasiones.
Leer más → -
CI/CD con Datavault Builder en Snowflake
Cómo usar el Zero Copy Cloning de Snowflake con Datavault Builder para construir una pipeline CI/CD potente para su data warehouse.
Leer más → -
¿Importan siempre los Equi-Joins?
De vez en cuando me topo con afirmaciones sobre cómo funcionan las bases de datos y cómo deberían consultarse. Y me gusta leer esas recomendaciones.
Leer más → -
3NF y Data Vault: nada que temer
De vez en cuando recibimos una pregunta interesante: ¿Datavault Builder soporta 3NF? La respuesta es sí — y así funciona.
Leer más → -
Temporalidad DWH Pt.4: Dimensiones SCD Type 2
Dimensiones estilo Kimball — salida SCD Type 2. Si no las ha leído, recomiendo leer primero las 3 primeras partes.
Leer más → -
Temporalidad DWH Parte 3: Sacar las timelines
Aunque en muchos casos no es necesario sacar las timelines en los informes, hay casos en los que sacar las timelines es importante.
Leer más → -
Temporalidad DWH Parte 2: Reducir complejidad
Cómo reducir la complejidad temporal en el Data Vault. Los usuarios de Datavault Builder preguntan a menudo cómo mapear correctamente cambios a lo largo del tiempo.
Leer más → -
Temporalidad DWH Parte 1: El reto
En los últimos años me he enfrentado a la demanda de crear un reporting con dimensiones SCD type 2.
Leer más → -
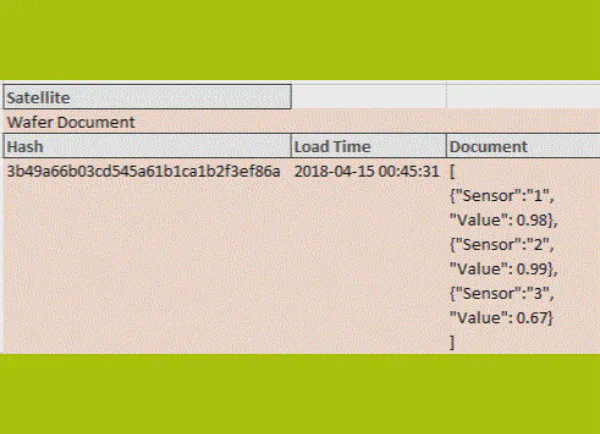
Sobre Multi-Active Satellites en Data Vault
Petr Beles sobre la implementación de Multi-Active Satellites como Document Satellites en Data Vault: patrones, compromisos y guía práctica.
Leer más → -
Sobre Links
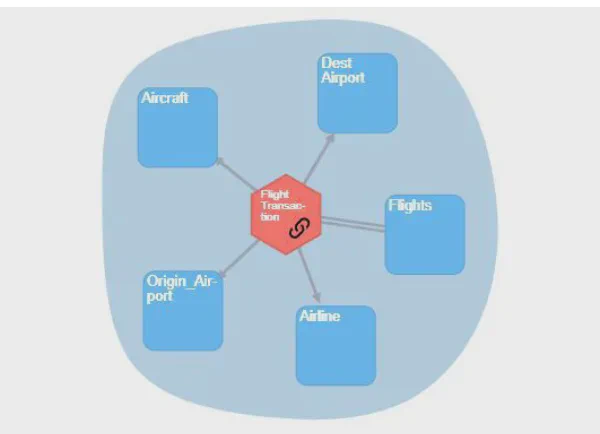
Petr Beles sobre los links de Data Vault que representan transacciones: patrones, trampas y decisiones de diseño al modelar transaction links.
Leer más → -
Qlik
¿Sus aplicaciones de Qlik y sus informes de Power BI muestran cifras distintas?
Ni Qlik ni Power BI se equivocan. Cada uno tiene su propia lógica de carga, sus propias definiciones y su propio lineage, así que la misma métrica se calcula dos veces y nadie puede conciliarlas. Las reglas deben estar en un único modelo gobernado del warehouse que lean ambas herramientas.
Leer más → -
Tableau
¿Su Tableau Server tiene demasiadas versiones de la misma cifra?
Cada .tdsx publicado era razonable el día en que se creó. Juntos son cientos de definiciones privadas de la misma métrica, sin forma de saber cuál es la correcta.
Leer más → -
Power BI
¿Sus informes de Power BI muestran cifras distintas para lo mismo?
Finanzas, Ventas y Operaciones construyeron cada uno su propio modelo semántico, y cada uno es coherente en sí mismo. Las definiciones nunca fueron erróneas en un lugar. Nunca se acordaron en ninguno.
Leer más → -
Qlik
¿Limpia los mismos datos una y otra vez en cada script de carga de Qlik?
Los mismos mapping loads, correcciones de cadenas y eliminación de duplicados se escriben de nuevo en cada aplicación y en cada capa de QVD, y las copias acaban divergiendo. La limpieza se repite en cada script porque ninguna capa integrada del warehouse la hace una sola vez.
Leer más → -
Qlik
¿Sus expresiones de Set Analysis en Qlik son demasiado largas y lentas?
Set Analysis es preciso para comparaciones genuinas. La mayoría de las expresiones largas de su aplicación están ahí porque el modelo nunca entregó historial, indicadores ni una única granularidad, así que el gráfico los reconstruye con cada selección.
Leer más → -
Tableau
¿Sus expresiones LOD de Tableau son demasiado complejas para tocarlas?
FIXED, INCLUDE y EXCLUDE son herramientas precisas para preguntas genuinas con varias granularidades. La mayoría de las que hay en su libro de trabajo están ahí porque el warehouse nunca resolvió la granularidad ni guardó el historial.
Leer más → -
Power BI
¿Su informe DirectQuery de Power BI va lento con cada clic?
DirectQuery y Direct Lake prometen datos en vivo. Lo que obtiene es un objeto visual de treinta segundos y una factura de cómputo que nadie quiere explicar. El modo no es el problema. El esquema que tiene debajo sí lo es.
Leer más → -
Qlik
¿Sus aplicaciones de Qlik crean claves sintéticas una y otra vez?
Las claves sintéticas y las referencias circulares son Qlik asociando exactamente lo que recibe. Aparecen porque los datos llegan sin dimensiones conformadas ni claves reales, así que cada aplicación tiene que inventarlas.
Leer más → -
Qlik
¿Sus recargas de Qlik fallan cada vez más a medida que crecen los datos?
El motor en memoria es rápido porque todo está en la RAM. Las recargas fallan y las aplicaciones se ralentizan cuando esa RAM se llena de detalle a nivel de fila y de transformaciones que ningún warehouse hizo antes.
Leer más → -
Tableau
¿Sus extracts de Tableau fallan al actualizarse o terminan tarde?
El backgrounder agota el tiempo de espera, el archivo .hyper no deja de crecer y el dashboard muestra los datos de ayer. El extract es grande porque arrastra filas en bruto que nunca se agregaron en el origen.
Leer más → -
Power BI
¿Su DAX de Power BI se está volviendo demasiado largo para mantenerlo?
Doscientas líneas de CALCULATE y FILTER no son señal de un DAX avanzado. Normalmente son señal de que el warehouse nunca le dio las claves, el historial o la granularidad que necesitaba.
Leer más → -
Tableau
¿Su dashboard de Tableau va lento cada vez que cambia un filtro?
Veinte segundos de "Ejecutando consulta" con cada clic en un filtro. Tableau no está dibujando despacio. Está esperando a una base de datos a la que se le hizo una pregunta que no puede responder rápido.
Leer más → -
Power BI
¿Su actualización de Power BI falla cada noche?
La actualización programada agota el tiempo de espera, Power Query se queda sin memoria y usted se entera cuando alguien abre el dashboard. La causa casi nunca es Power BI. Es lo que se le pide a Power BI que haga.
Leer más →








Aquí todavía no hay nada.